[Paper Review, KR] MotionStream: Real-Time Video Generation with Interactive Motion Controls
Paper Information
Title: MotionStream: Real-Time Video Generation with Interactive Motion Controls
Authors: Joonghyuk Shin, Zhengqi Li, Richard Zhang, Jun-Yan Zhu, Jaesik Park, Eli Shechtman, Xun Huang
Venue: ICLR 2026 Oral
Link: [Paper], [Project], [GitHub]
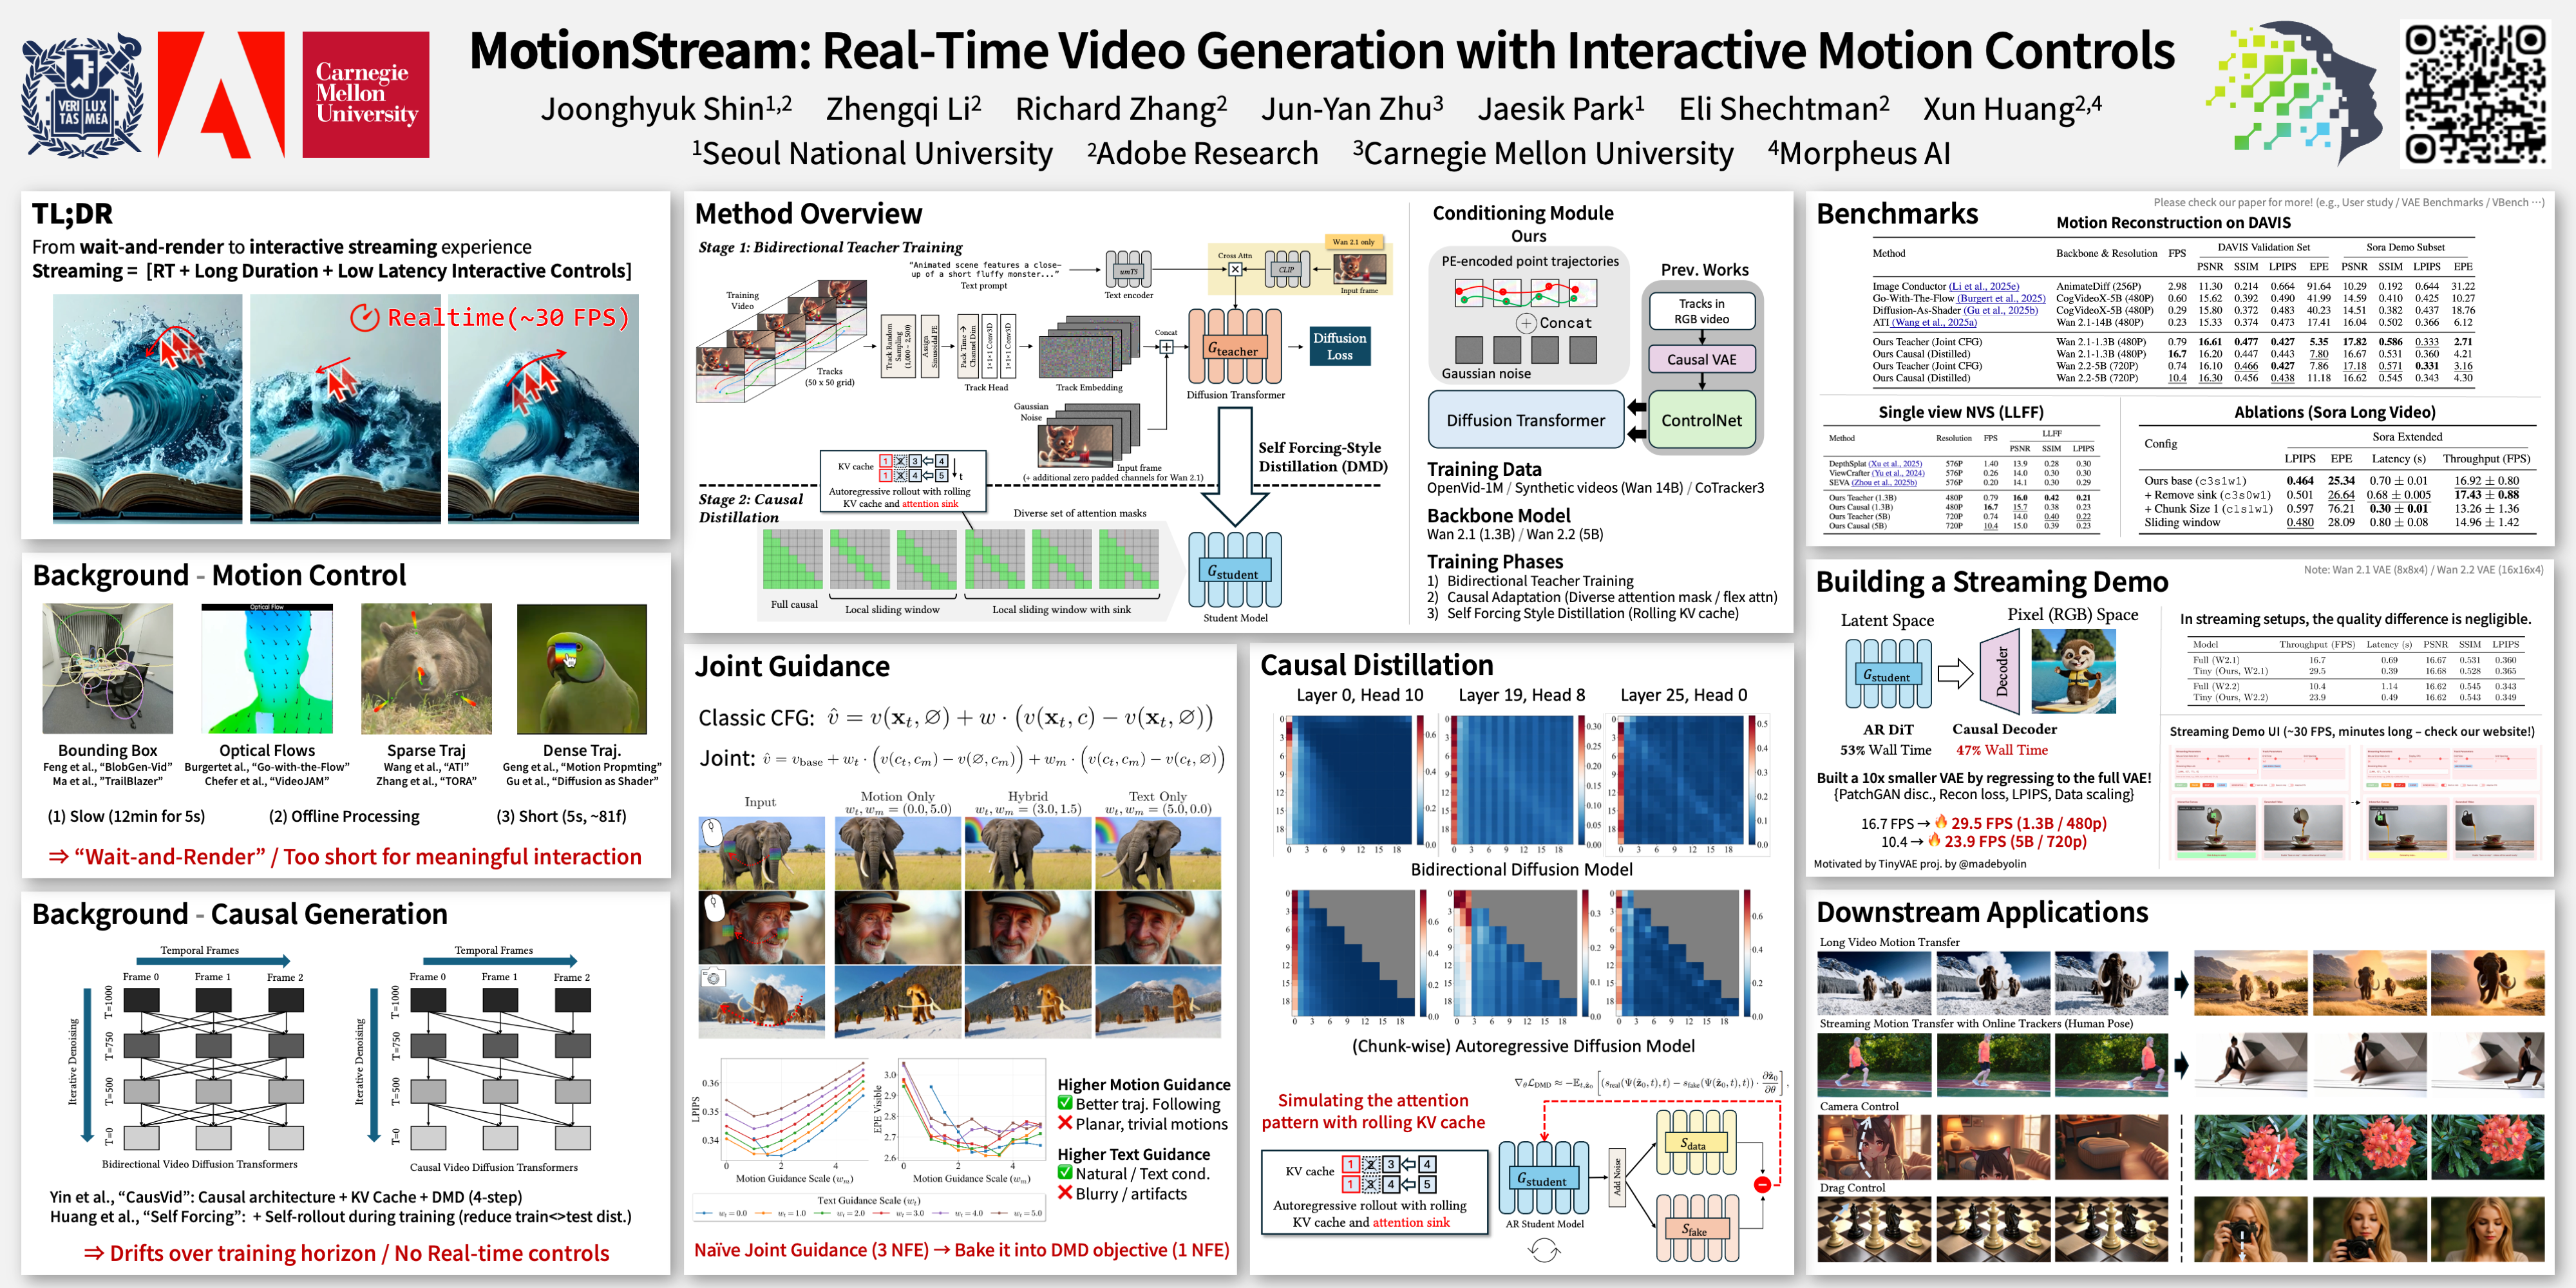
Teaser Image (Poster)
Introduction
Motion-controlled video generation은 사용자가 객체, 인물, 카메라의 움직임을 직접 지정할 수 있도록 발전해 왔다. 초기에는 구조(structure), 카메라, subject, audio 등 다양한 조건을 활용하는 controllable video generation 연구가 진행되었고, 이후 motion 자체가 영상의 동역학을 직접 표현하는 중요한 conditioning signal로 자리 잡으면서 optical flow, 2D/3D trajectory, bounding box, semantic segmentation 등 다양한 motion representation이 활용되기 시작했다. 최근 video diffusion model들은 이러한 조건을 이용해 높은 화질과 정교한 trajectory following을 달성했지만, 대부분 전체 영상과 전체 motion condition을 한 번에 처리하는 bidirectional diffusion 구조에 기반한다. 따라서 사용자가 미래의 trajectory를 모두 미리 지정해야 하며, 생성 중간에 결과를 확인하거나 motion을 수정하기 어렵다. 또한 diffusion의 반복적인 denoising 과정 때문에 생성 속도가 매우 느린데, 논문에서는 Motion Prompting의 경우 5초 영상을 생성하는 데 약 12분이 소요되는 사례를 들고 있다. 결국 기존 motion-controlled video generation은 높은 품질과 제어 능력에도 불구하고 느린 생성 속도, non-causal processing, 짧은 생성 길이 때문에 실시간 상호작용에는 적합하지 않았다.
한편 video generation의 시간적 생성 방식은 초기 GAN 기반 autoregressive/parallel video synthesis에서 시작하여, 이후 denoising objective를 사용하는 video diffusion model과 next-token prediction 기반 autoregressive video model로 발전해 왔으며, 최근에는 두 방식을 결합해 causal하면서도 고품질인 AR-diffusion 모델을 만드는 연구가 활발하다. 특히 느린 bidirectional diffusion teacher를 빠른 autoregressive student로 distillation하는 방식이 등장하면서 real-time generation 가능성이 커졌지만, 이러한 모델들은 학습한 sequence 길이를 넘어 장시간 생성할 경우 color drift나 품질 저하가 누적되거나, 이를 방지하기 위해 복잡한 long-video fine-tuning이 필요하다는 한계가 있다. 동시에 Genie 계열과 같은 interactive video world model 연구도 실시간 user interaction을 목표로 발전하고 있지만, 많은 방법이 매우 큰 inference compute를 요구하거나 Minecraft·게임과 같은 closed-domain 또는 synthetic environment에 제한되어 있다. 따라서 기존 연구들은 각각 controllability, causal generation, real-time interaction 중 일부는 달성했지만, open-domain photorealistic video에서 motion control을 유지하면서 장시간 안정적으로 실시간 생성하는 문제는 여전히 해결되지 않은 과제로 남아 있다.
Method & Technical Details
Adding Motion Controls to Bidirectional Teacher Models
해당 Technique의 핵심은
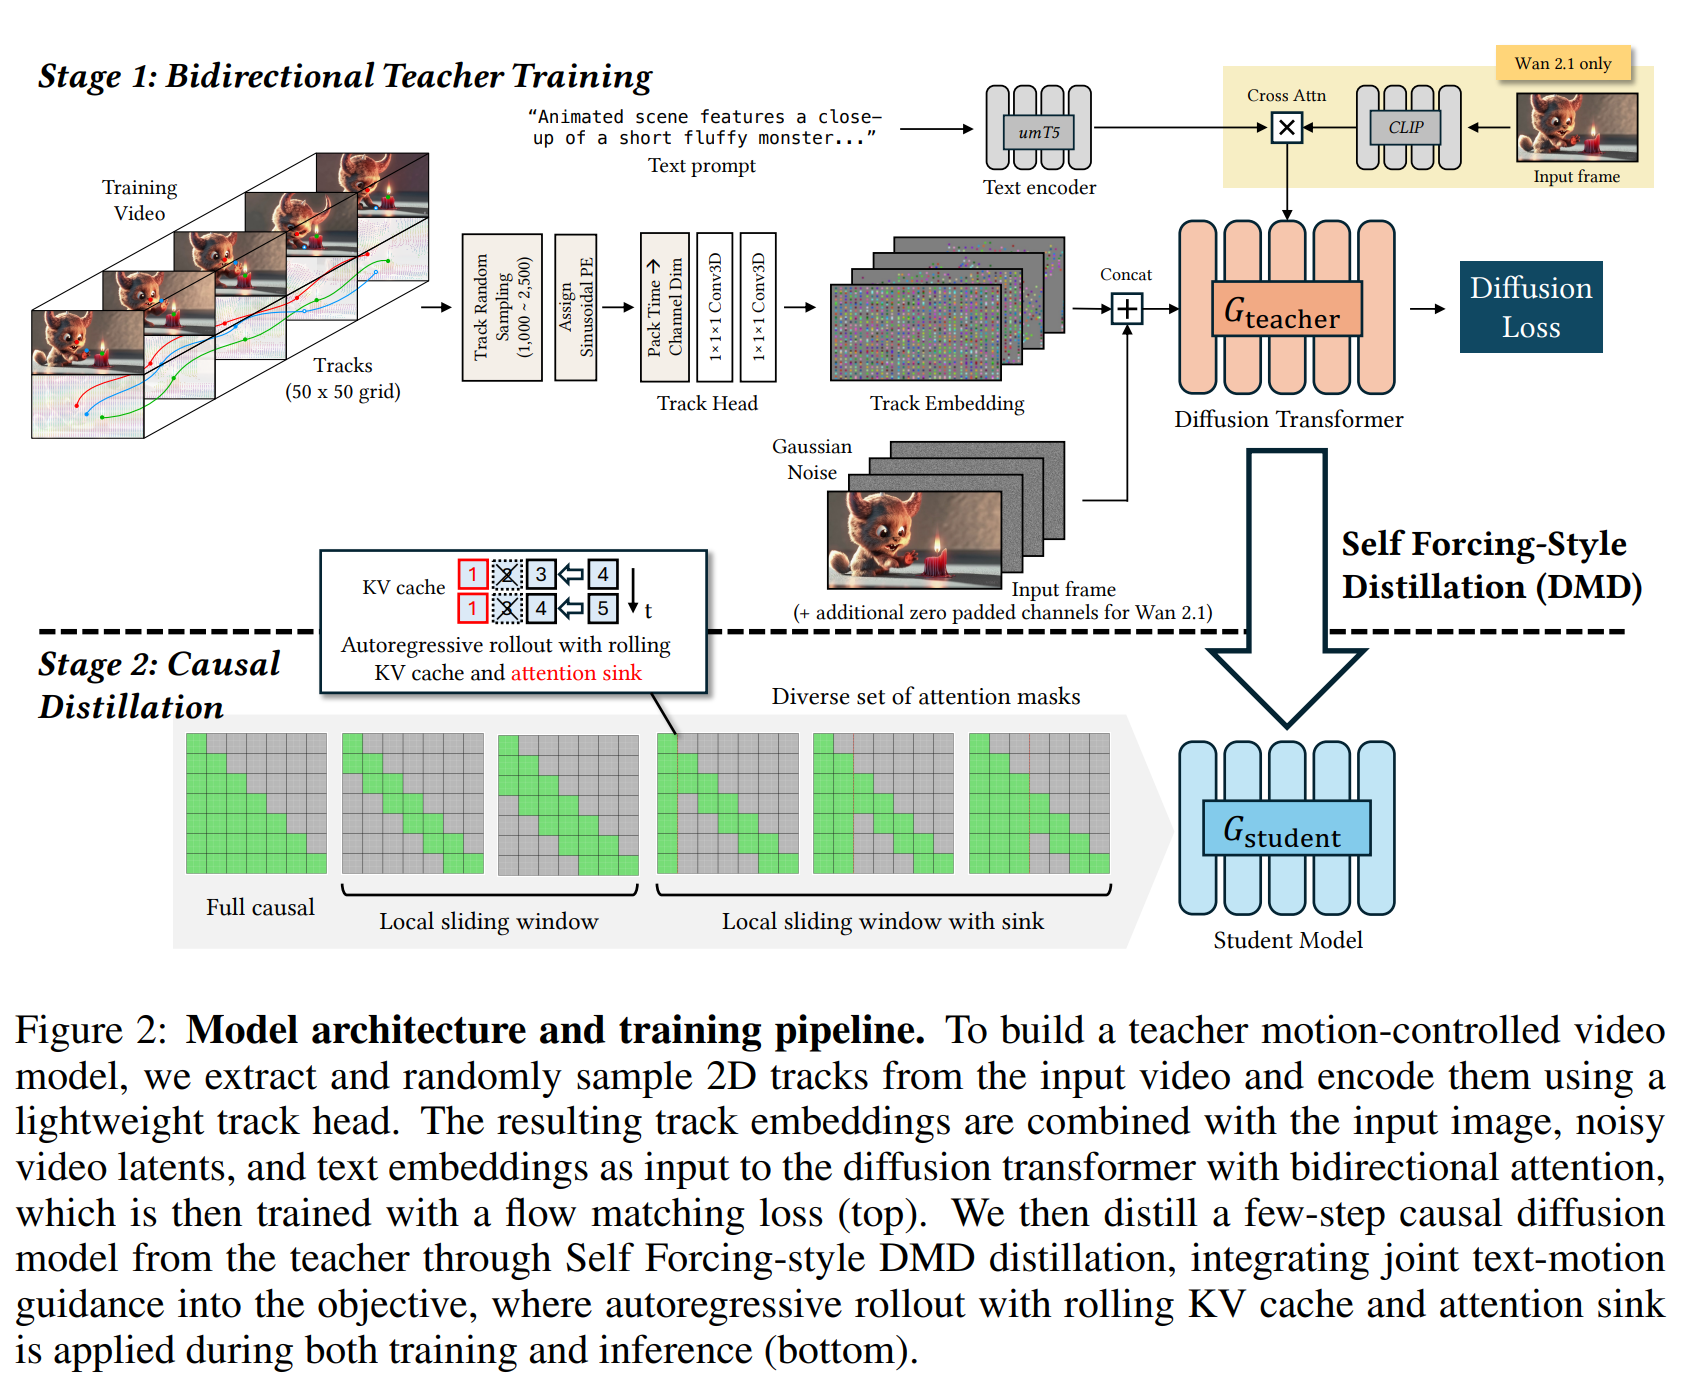
기존 Wan 계열의 bidirectional video diffusion model에 motion trajectory를 조건으로 넣을 수 있는 기능을 추가해서 teacher model을 만드는 것
이다.
즉, motion을 정확히 잘 따르는 고품질 teacher를 만드는 단계라고 보면 된다.
먼저, 입력 motion을 어떻게 표현할지부터 생각을 해보아야 한다. 즉, Track Representation을 생각해보자.
일단, 입력 motion은 여러 개의 2D point trajectory로 표현된다. 어떤 점 $n$이 시간에 따라
\[(x_t^n, y_t^n)\]처럼 움직인다고 생각하면 된다. 각 track에는 고유한 $d$-dimensional embedding $\phi_n$을 부여한다. 이 embedding은 학습 가능한 ID embedding이 아닌, random ID에 sinusoidal positional encoding을 적용해서 만든 값이다. 즉,
- track 1 $\rightarrow$ $\phi_1$
- track 2 $\rightarrow$ $\phi_2$
- track 3 $\rightarrow$ $\phi_3$
처럼 각 trajectory를 서로 구분할 수 있는 identity가 생긴다. 그리고 각 프레임 $t$에서 그 track의 위치에 해당 embedding을 놓는다. (자 이렇게 보면 어려운 기술 용어들이 나와서 어렵다. 아래의 detail을 눌러서 좀 더 자세하게 확인해보는게 좋다)
Track Representation
많은 4D Generation 논문들을 보면 track에 관한 개념이 많이 등장한다 track이라는 것은 비디오 프레임 흐름에 따라 하나의 점이 프레임이 바뀌었을 때 어디로 이동하는지를 알려주는 표현 방식이라고 생각하면 된다.
그러니까 $t=1$일 때 $(100,200)$ 에 있던 하나의 점이 $t=2$가 되니까 $(105,201)$ 에 있을 때, 이 track을 우리는 이와 같이 표현한다:
\[\{(x_t^n, y_t^n)\}_{t=1}^T = \{(100,200), (105,201)\}\]MotionStream은 실제 학습 데이터에서 CoTracker3라는 모델을 통해 추적한다. 그리고 CoTracker3를 통해 2500개의 점을 추적하고, 학습 시 그중 1000~2500개를 random sampling 한다.
논문에서는 각 2D track마다 randomly sampled ID number를 하나 부여한다고 되어 있다. 그런데 scalar인 ID number를 그대로 모델에 넣는 것보다 고차원 vector로 바꾸는 것이 유용하여 ID number를 $d$-dimensional vector로 바꾼다. 이를 embedding이라고 부른다. MotionStream에서는 $d=64$로 설정하여 한 track의 ID를 64차원 vector로 표현한다.
따라서 예시로,
\[ID = 17\]인 Track이 있을 때, 이 ID를
\[\phi_{17} = [0.21, -0.84, 0.56, ...] \in \mathbb{R}^{64}\]로 바꾸는 것이다. 그런데, ID를 Vector로 바꿀 때 사용하는 방식이 바로 Sinusoidal Positional Encoding이다. ID $p$에 대해
\[[sin(p),cos(p),sin(p/10),cos(p/10), ...]\]처럼 여러 frequency의 sin/cos 값을 만들어 하나의 vector로 만든다. 그래서 ID가 다르면 서로 다른 vector가 만들어진다는 것이 핵심이다.
이 다음으로 수식이 등장한다.
\[c_m \left[ t, \left\lfloor \frac{y_t^n}{s} \right\rfloor, \left\lfloor \frac{x_t^n}{s} \right\rfloor \right] = v[t, n]\phi_n\]이 수식의 의미는 VAE latent resolution에 맞게 downsample한 위치에 embedding을 찍는 방식을 말한다.
먼저, $c_m$은 motion conditioning tensor다. 논문에서는 shape을 $c_m \in \mathbb{R}^{T \times H/s \times W/s \times d}$로 정의한다. 축을 하나씩 보면, (시간, 세로 위치, 가로 위치, track embedding)이다. 즉, 각 frame마다 $H/s \times W/s$ 크기의 map이 하나 있고, 각 위치마다 $d$-dimensional vector를 넣을 수 있는 tensor다.
원래 track 위치는 원본 video pixel 좌표다. 예를 들어 spatial compression이 $s=8$이고, $H=480, W=832$라고 한다면, diffusion model은 원본 RGB 영상을 직접 처리하지 않고 VAE로 압축된 latent를 처리하기 때문에 $480 \times 832$가 $60 \times 104$ 정도로 작아진다. 따라서, 원본 pixel에서 track이
\[(x,y) = (320,160)\]에 있다면 latent coordinate에서는
\[(\frac{320}{8}, \frac{160}{8}) = (40,20)\]이다. 그래서 식에서
\[\left\lfloor \frac{y_t^n}{s} \right\rfloor, \left\lfloor \frac{x_t^n}{s} \right\rfloor\]를 사용한다. 그리고 track의 visibility에 대해 이야기하자면, 모든 track이 모든 frame에서 보이는 것이 아니다. 예를 들어 사람이 다른 사람 뒤로 가려지면 특정 point가 안 보일 수 있다. 이를 나타내는 것이
\[v[t,n] \in \{0,1\}\]이다. 보이면 1의 값을 갖게 되어
\[c_m[ \cdots ] = \phi_n\]이고, 가려져 안 보이면 0의 값을 갖게 되어
\[c_m[ \cdots ] = 0\]이 된다. 즉, visibility mask 역할을 수행하는 것이 $v[t,n]$이다. 그 다음으로 Track head에 대해 이야기해보자. 이제 만든 $c_m$을 바로 diffusion transformer에 넣는 게 아니라, 작은 network를 통과시킨다. 이게 바로 track head다.
흐름은 대략
\[\text{2D Tracks} \rightarrow \text{Sinusoidal ID Embedding} \rightarrow c_m \rightarrow \text{Track Head}\]이다. Track head는 먼저 4x temporal compression을 수행한다. 이유는 Wan의 VAE가 video latent를 시간축에서도 압축하기 때문이다. 원본 track은 frame마다 존재하지만, video latent는 temporal resolution이 더 작다. 따라서 motion condition도 같은 시간 해상도로 맞춰야 한다.
그 뒤에 $1 \times 1 \times 1 \;\; Conv3D$를 사용한다. 이 convolution은 각 위치에 존재하는 feature vector를 원하는 channel dimension으로 projection하는 가벼운 layer다.
그런데, 기존의 controllable diffusion에서는 ControlNet 스타일 구조를 많이 사용하지만 해당 논문의 경우에는 단순한 방식으로 처리한다. 이 이유에 대해 논문의 저자들은 ControlNet은 원래 backbone과 유사한 network branch를 하나 더 추가하는 방식이라 계산량이 많이 증가하기 때문이라고 답한다. 따라서, MotionStream의 목표인 real-time rendering과 맞지 않아 이를 넣지 않는다.
그래서 track head로 처리한 motion feature를 video latent에 직접 channel-wise concatenation한다:
\[[\text{video latent} || \text{motion feature}]\]이를 통해 ControlNet과 같이 backbone을 복제하지 않고 motion control을 추가할 수 있었다.
다음으로 이 teacher를 어떻게 학습할지에 대해 논의한다. 논문의 저자들은 rectified flow matching objective로 학습을 진행한다. 입력은 개념적으로 $z_t + \text{text} + \text{motion condition}$이고, 출력은 $\text{velocity prediction}$이다. 그래서 이 teacher는 text도 따르고, track trajectory도 따르는 video generator로 학습된다.
그런데 여기서 문제가 있다. 우리가 이전 수식에서 track visibility를 표현하기 위해 $v[t,n]$을 사용했었다. 그래서 이 값이 0이면 해당 위치의 motion feature가 0이 된다. 그런데 사용자가 interaction 중에 control을 중단하게 되면 motion signal이 없어지므로 이 경우에도 0이 된다. 즉 모델 입장에서는 0이라는 값을 보고 track이 가려져서 0이 된 건지 사용자가 track을 더 이상 지정하지 않는 것인지 구분이 힘들다.
이는 모델이 track이 사라진 것이 object가 사라진 것이라고 판단하는 오류를 발생할 수 있다. 논문에서는 이 경우에 object가 갑자기 나타나거나 사라지는 artifact가 생길 수 있다고 설명한다. 그래서 논문은 Stochastic mid-frame masking이라는 방법을 사용한다.
이 방법은 일부 frame에서 일부러 motion signal을 없애는 방식이다. 논문에서는
\[c_m[t_{rand}, :, :] = 0\]로 만들고 확률은 $p_{mask}=0.2$다. 이 방법의 의미는 중간에 motion condition이 갑자기 없어져도 video 자체는 자연스럽게 이어져야 한다는 것을 학습시키는 것이다. 물론, 이 방법을 처음부터 사용하지는 않고, 먼저 이 방법을 사용하지 않은 상태에서 motion track을 정확하게 따라가는 능력을 학습시키고 난 뒤에 이 방법을 추가해서 사용한다.
논문에서는 text condition을 $c_t$, motion condition은 $c_m$이라고 표현하고 이 두 condition의 역할은 다르다. 그런데, 두 condition guidance 중 하나가 너무 강하면 object가 너무 rigid하고 simplistic하게 이동하거나(motion guidance가 너무 클 때), user가 지정한 trajectory를 벗어날 수 있다(text guidance가 너무 클 경우).
따라서, 두 guidance의 균형이 필요하며 논문의 저자들은 joint guidance를 사용한다:
\[\hat{v} = v_{\mathrm{base}} + w_t \left( v(c_t, c_m) - v(\emptyset, c_m) \right) + w_m \left( v(c_t, c_m) - v(c_t, \emptyset) \right)\] \[v_{\mathrm{base}} = \alpha v(\emptyset, c_m) + (1-\alpha)v(c_t, \emptyset), \qquad \alpha = \frac{w_t}{w_t+w_m}\]MotionStream의 teacher는 rectified flow model이라서, 매 denoising step마다 현재 noisy latent $z_t$를 보고 velocity $v(z_t, t, c_t, c_m)$ 를 예측한다. 그리고 이 velocity를 따라서 latent를 조금씩 clean video 방향으로 이동시킨다. 그런데, 그냥 $v(c_t, c_m)$을 사용하는 대신, CFG처럼 text와 motion condition의 영향을 강조해서 최종 velocity를 만든다. 이게 바로 위의 $\hat{v}$에 대한 수식이다. 따라서 흐름은
\[\text{Model Predictions} \rightarrow \text{joint guidance를 통해 구한} \; \hat{v} \rightarrow \text{next denoising step}\]이 된다. 위의 $\hat{v}$의 수식을 보면, 그냥 $v(c_t, c_m)$을 사용하지 않고 좀 복잡하게 되어있다. 이는 CFG의 아이디어에서 비롯된 것인데, 이 condition을 넣었을 때와 안 넣었을 때 prediction이 얼마나 달라지는지 보고, 그 차이를 더 강하게 민다는 컨셉이다.
여기서,
\[v(c_t, c_m) - v(\cancel{0}, c_m)\]는 text effect에 대해 보여주고, 이는 text가 velocity prediction에 추가한 방향을 알려준다. 그리고 $w_t$를 곱해서 text의 영향을 조절한다. 반대로
\[v(c_t, c_m) - v(c_t, \cancel{0})\]는 text는 같은데 motion만 다르다. 따라서 motion trajectory가 추가한 방향이라고 볼 수 있고, $w_m$을 곱해서 motion adherence를 조절한다. $\hat{v}$ 수식 밑에 $v_{base}$ 수식도 motion-only prediction, text-only prediction을 섞어서 만드는 것을 볼 수 있다.
그러나 이 joint guidance도 단점을 가지고 있다. joint guidance 방식을 사용하면 품질은 좋아지지만 계산량이 늘어난다. 왜냐하면 한 번의 denoising step에서
\[v(c_t, c_m), v(\cancel{0}, c_m), v(c_t, \cancel{0})\]를 각각 계산해야 하기 때문에 3 NFE(Number of Function Evaluations)가 필요하다. 그래서 이 teacher는 그 자체로는 real-time 모델이 아니다.
그래서, 최종적으로 teacher model을 학습하는 방식에서 가장 중요한 기법들은 Track Representation, Track Head, Stochastic Mid-frame Masking, Joint Text-Motion Guidance라고 볼 수 있다.
Causal Distillation
Teacher model은 현재 bidirectional diffusion model이다. 예를 들어 81 frame 영상을 만든다고 하면 teacher는 frame 전체를 한꺼번에 보고 attention을 한다. 그래서 10 frame 하나를 처리할 때도 전체 1~81 temporal context를 이용할 수 있다. 이 방식은 좋은 품질을 내기에는 유리하지만 실시간 interaction에는 문제가 있다. 사용자가 아직 미래 trajectory를 그리지 않았다면 미래 frame에 대한 control signal 자체가 없다. 그래서 현재까지 입력된 trajectory만 가지고 바로 영상을 만들어야 하는 real-time 상황에는 맞지 않다. 그래서
student는 $1 \rightarrow 2 \rightarrow 3 \rightarrow …$ 처럼 앞에서 생성한 결과만 보면서 다음 부분을 생성하는 causal model이 되어야 한다.
단순히 causal attention 방식을 사용하는 Self Forcing 방식을 그대로 사용하는 것도 문제가 있다고 설명한다. 첫 번째는 training horizon 밖으로 나가면 quality가 급격히 무너지는 것이다. 왜냐하면, teacher가 81 frame 정도의 영상만 학습했다고 가정한다면, student도 그 정도 길이의 영상을 생성하는 것은 잘하지만, 83 frame을 넘어 생성하기 시작할 때부터 error가 누적되거나 geometry가 이상해지는 등의 문제가 발생할 수 있다.
그리고 두 번째로 attention context가 길이에 따라 달라지면 latency가 일정하지 않다는 점이다. full causal attention의 경우에 frame의 길이가 길어질수록 과거는 계속 쌓인다. 그리고 context도 같이 커지게 되는데, 이러면 긴 영상을 만들수록 attention cost도 커지게 된다. 이는 실시간 streaming에서는 치명적이다.
그래서 Sliding Window Attention을 사용한다. 이는 단순한 해결책으로서 모든 과거를 보지 않고 최근 일부만 보는 방식이다. 그런데 이 기법 또한 문제가 있다. 오래 생성하다 보면 첫 번째 input image에 대한 정보가 window 밖으로 밀려난다면, error가 frame을 거칠 때마다 조금씩 생기고 이게 누적되는 문제가 발생한다. 이를 autoregressive error accumulation / drift라고 한다.
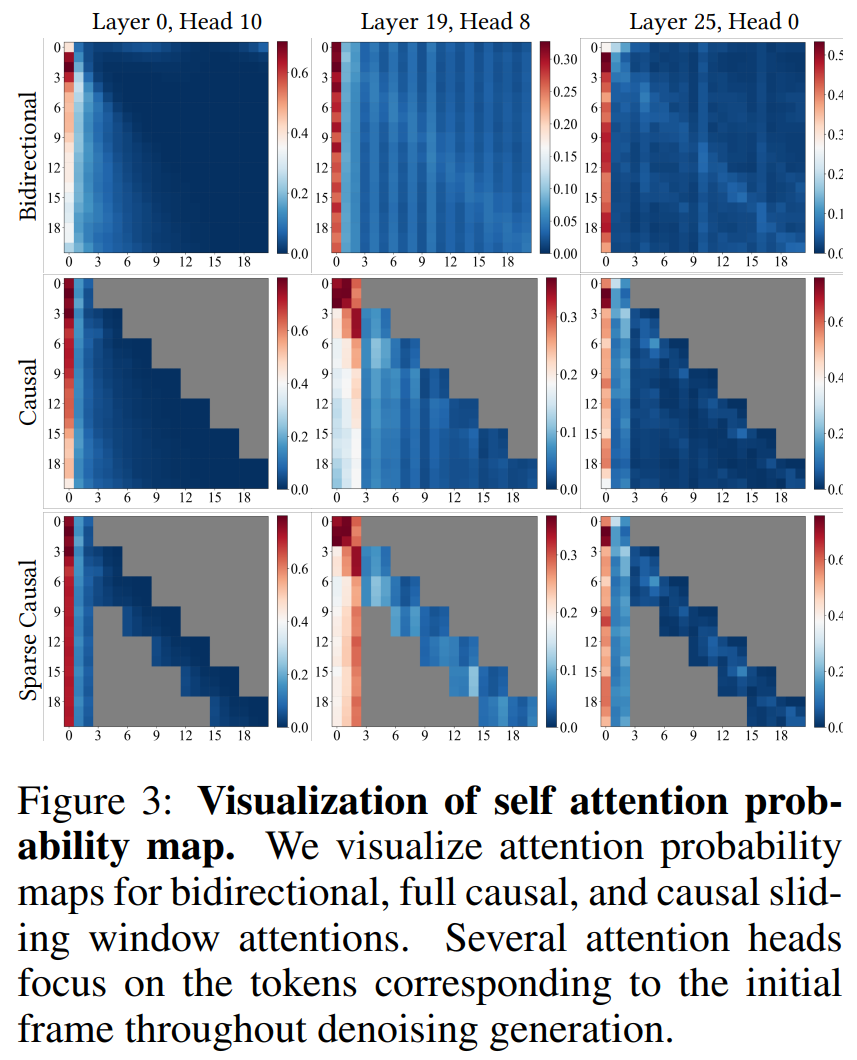
그리고 저자들은 self-attention map을 직접 확인한다. 그게 위에 있는 figure 3 이미지다. 이를 통해 bidirectional 이든 causal이든 많은 attention head가 계속해서 초기 frame의 token에 강하게 attention하는 현상을 발견한다. 즉 모델 입장에서 첫 frame은 그냥 오래된 frame 하나가 아니라 “영상의 identity와 scene을 유지하기 위한 anchor”의 역할을 수행하고 있다는 것이다. 논문의 저자들은 이를 LLM의 streamingLLM에서 발견된 attention sink와 비슷하다고 보았다.
그래서 논문의 저자들은
sliding window를 쓰되, 맨 처음 frame은 버리지 않는 방식으로 진행한다.
논문에서는 첫 chunk는 항상 고정되어 있기 때문에 model이 오래 생성하더라도 원래 scene이나 identity를 계속 anchor 할 수 있다고 말하며, 이를 sink chunk라고 부른다.
자 그러면 논문에서 말하는 rolling window에 대해서 알아야 한다. 우리는 앞서 sink와 window의 필요성과 무엇인지에 대해 이해를 했다. 그래서 우리에게는 이제 두 가지 hyperparameter가 존재한다:
\[S = \text{number of sink chunks}, W = \text{local window size}\]만약, $S=1, W=2$ 인 상태에서 chunk 11을 생성할 때, $[1,9,10]$이 된다. 즉 sink chunk는 그대로 있고 local window만 이동하게 된다.
student의 작동 구조는 파악했다. 그런데, bidirectional teacher의 weight를 바로 causal student에 넣으면 잘 동작하지 않는다. teacher는 원래 past와 future를 모두 볼 수 있도록 학습되어 있다. 그런데 student는 past만 볼 수 있다. 그래서 먼저 teacher weight로 student를 initialize한 뒤, causal architecture에 적응시키는 단계가 필요하다. 이를 위해 다양한 context window size, attention sink size를 가지는 attention mask를 사용한다. 이렇게 되면 student가 특정 하나의 causal pattern에만 익숙해지지 않고 여러 causal context에 적응하도록 한다. 논문의 저자들은 이를 Causal Adaptation이라고 표현한다.
이제 본격적으로 distillation 방식을 설명하려고 한다. MotionStream의 경우 기존의 Self-forcing 기법 기반의 distillation 방식을 채택한다. Self-forcing 기법을 간단하게 설명하면, 일반적인 autoregressive training에서 학습할 때 보통 ground-truth previous frame을 condition으로 준다. 그리고 그 다음 frame을 예측하도록 하는데, 문제는 inference 때는 ground truth가 없다는 점이다.
그래서 자기가 생성한 결과를 다시 condition으로 사용해야 한다. 문제는 학습할 때는 깨끗한 input(GT)를 봤는데 inference에서는 자기 error가 들어간 input을 계속 보아야 한다. 이를 train-test gap이라고 생각하면 된다. Self Forcing은 이걸 해결하기 위해서 학습 중에도 실제 inference처럼 자기가 생성한 결과를 다음 입력으로 사용하도록 한다.
이제 MotionStream의 distillation 동작에 대해 설명하고자 한다.
먼저, 논문에서는 전체 video latent를 L개의 chunk로 나눈다.
\[\{z_t^i\}_{i=1}^L\]여기서 $i$는 chunk index로 사용한다. 현재 $i$번째 chunk를 생성할 때 사용할 context를 논문은
\[C_i = \{z_t^i\} \cup \{z_0^j\}_{j \le S} \cup \{z_0^j\}_{\text{max(1, i-W)} \le j < i}\]이렇게 표현한다. 즉, “현재 noisy chunk + initial sink + recent generated chunks” 이다. 그래서 전체 video probability는
\[p_{\theta}(z_0^{1:L}) = \prod_{i=1}^{L} p_{\theta}(z_0^i \mid C_i)\]로 표현된다. 이는 chunk 1을 만들고, 그것을 보고 chunk 2를 만들고, 앞의 결과를 보고 chunk 3을 만들고 … 이 방식이다. 즉, causal autoregressive generation이다.
추가적으로, KV Cache를 사용해서 Rolling KV Cache라는 컨셉을 사용한다. 모든 과거 KV를 저장하면 결국 memory와 attention cost가 계속 증가하므로 MotionStream은 Sink KV + Recent window KV만 남긴다는 것이다. 그래서 KV Cache에서 업데이트되는 주체는 Sink Chunk가 아니라 window Chunk 부분이 계속 업데이트된다. 예를 들어, $S=1, W=2$라고 한다면 현재 10 chunk를 생성할 때 현재 cache에는 [1,8,9]가 있고, 10 chunk를 생성하고 [1,9,10]로 KV Cache가 갱신되는 것이다.
그리고 training에서도 rolling 방식으로 학습한다. 기존 방법 중에는 training에서 causal attention mask를 쓰고, inference에서만 rolling cache를 사용하는 경우가 있다. 그러면 training과 inference가 정확히 일치하지 않으니 MotionStream은 학습 중에도
\[\text{self-rollout} + \text{rolling KV cache} + \text{attention sink}\]를 그대로 사용하며 논문은 이를 extrapolation-aware training이라고 표현한다. Distillation 방식은 기존의 DMD 방식을 채택한다. DMD 관련 설명은 FlashWorld 논문 리뷰 게시글의 Preliminary 섹션에 적혀 있으니 확인하길 바란다.
DMD의 distillation 방식을 사용하는데, 여기서 teacher의 경우 text guidance와 motion guidance를 동시에 사용했다. 그래서 teacher inference 시에는 3 NFE가 필요했는데, student의 경우에는 3 NFE를 유지하면 실시간 생성 목표에 차질이 생긴다. 그래서 이 비싼 guidance를 student에게 distill해서 내장한다. DMD에서는 teacher를 $s_{real}$, 즉 score estimator의 역할로 사용한다.
\[s_{\mathrm{real}} = s_{\mathrm{base}} + w_t \left( f_\phi(c_t,c_m)-f_\phi(\emptyset,c_m) \right) + w_m \left( f_\phi(c_t,c_m)-f_\phi(c_t,\emptyset) \right)\]이는 이전에 보았던 teacher 모델이 학습할 때 최종 guided velocity $\hat{v}$를 예측할 때 사용한 수식과 거의 동일하다. 논문은 이를 real-data score를 만드는 식이라고 말한다. 반면 fake score estimator는
\[s_{fake} = f_{\psi}(c_t, c_m)\]처럼 CFG 없이 한 번의 evaluation만 사용한다. 즉 student는 나중에 inference 할 때 별도로 text CFG와 motion CFG를 계산할 필요가 없다. 그래서 앞서 비싼 guidance를 student에게 distill해서 내장한다는 의미가 여기서 나온 것이다.
그런데 여기서 두 개의 network가 등장한다. $G_{\theta}$ 인 실제 video를 생성하는 student Generator와 $f_{\psi}$인 student가 현재 만들어내는 distribution의 score를 추정하는 fake score estimator다.
\[\nabla_{\theta} L_{\mathrm{DMD}} \approx - \mathbb{E}_{t,\hat{z}_0} \left[ \left( s_{\mathrm{real}}(\Psi(\hat{z}_0,t),t) - s_{\mathrm{fake}}(\Psi(\hat{z}_0,t),t) \right) \cdot \frac{\partial \hat{z}_0}{\partial \theta} \right]\]그럼 이제 DMD 수식을 살펴보면 논문이 목표로 하는 Generator를 real-time에서 생성할 수 있도록 하는 것이 보인다. 즉, Generator의 $\theta$를 업데이트하는 것이 목적이고, 이를 위해 critic이 추정한 score $s_{fake}$와 teacher score의 $s_{real}$의 차이를 통해 업데이트하는 것이다.
논문에서는 generator와 critic update 비율을 1:5로 둔다. critic을 더 자주 학습시켜서 현재 generator distribution을 잘 추적하도록 하는 것이다.
이외에도 Gradient truncation이라는 기법도 사용한다. Autoregressive self-rollout 전체에 gradient를 다 저장하면 memory가 많이 필요하다. Chunk $L$ 전부에 대해 여러 denoising step의 computation graph를 저장해야 하기 때문에 Self-Forcing에서 사용하는 gradient truncation을 적용한다.
denoising step 중 하나를 랜덤하게 고르고 그 step에 대해서만 gradient를 backpropagation 한다. 또 이전 frame의 KV cache는 stop-gradient 처리하여 과거 cache까지 gradient를 계속 따라가지 않는다. 이 덕분에 memory usage를 크게 줄일 수 있다.
Inference
이렇게 DMD 기법을 활용한 Student Generator의 학습이 끝나고 inference에서는
\[\text{sink chunks} + \text{recent local chunks}\]만 KV Cache에 유지한다. 그리고 새 chunk가 생성될 때마다 local window를 한 칸씩 굴린다. 그래서 영상이 아무리 길어져도 attention context 크기가 증가하지 않는다. 결과적으로 video length가 길어져도 per-chunk computational cost는 constant에 approximation 되어 유지할 수 있다.
Experiments
Implementation details
MotionStream은 Wan 2.1 I2V 1.3B와 Wan 2.2 I2V 5B를 backbone으로 사용한다. Teacher model은 OpenVid-1M과 Wan T2V 모델로 생성한 synthetic video를 이용해 학습하며, synthetic data는 Wan 2.1에 대해 약 70K, Wan 2.2에 대해 약 30K를 사용한다. Causal adaptation과 Self Forcing distillation 단계에서는 이 synthetic dataset에서 input image, text prompt, 2D motion track을 샘플링한다. 모든 real/synthetic video의 motion track은 CoTracker3를 사용해 50×50 uniform grid에서 추출하며, 자세한 학습 설정은 Appendix에 제시되어 있다.
Quantitative Evaluations
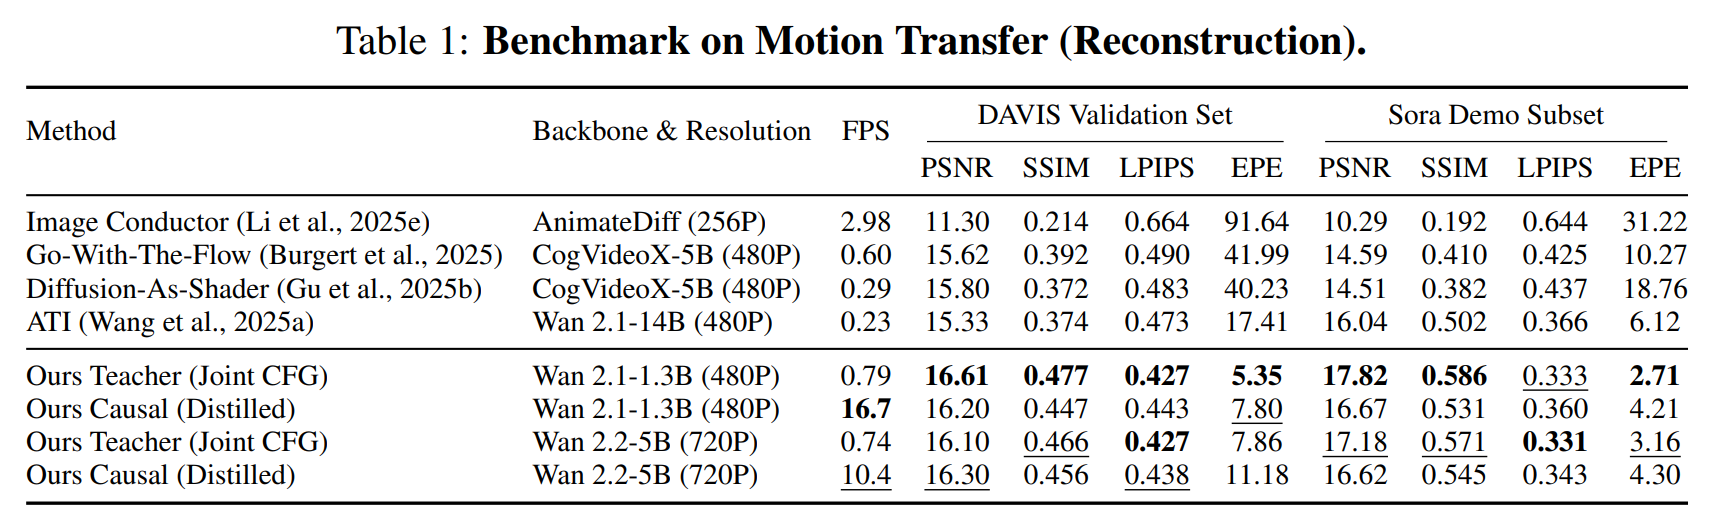
정량 평가는 Motion Transfer와 Camera Control 두 가지 task로 진행된다. Motion Transfer에서는 DAVIS validation set 30개 영상과 Sora demo subset 20개 영상을 사용하고, 생성 결과와 ground-truth를 직접 비교한다. PSNR, SSIM, LPIPS로 visual fidelity를, 입력 track과 생성 영상에서 추출한 track 사이의 EPE(End-Point Error)로 motion-following 정확도를 측정한다. Table 1에서 MotionStream의 teacher와 causal student는 기존 motion-controlled video generation 방법들과 비교해 높은 reconstruction 및 motion-following 성능을 보이며, causal student는 teacher 대비 일부 품질 저하가 있지만 16.7 FPS(480P), 10.4 FPS(720P)의 높은 generation throughput을 달성한다.
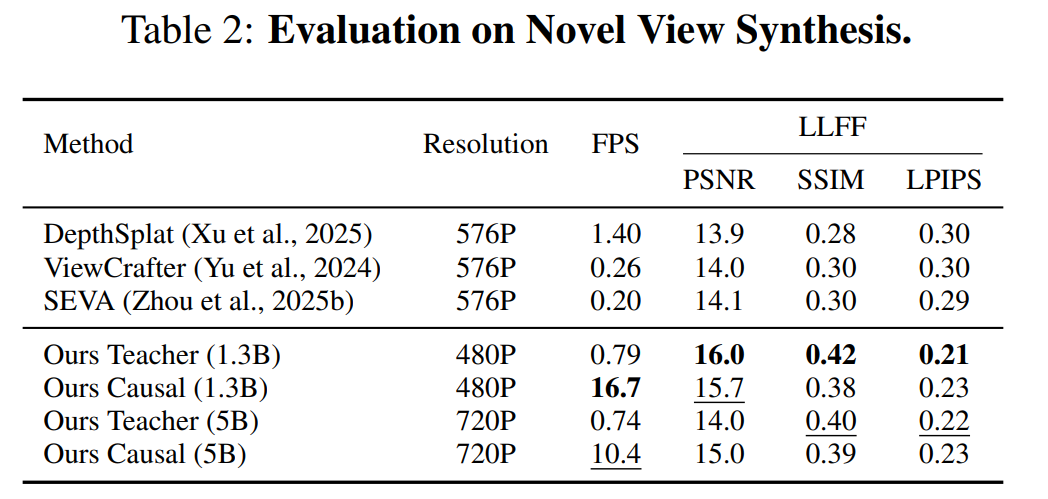
Camera Control에서는 MotionStream의 2D track control을 single-image novel view synthesis에 zero-shot으로 적용하여 LLFF dataset에서 평가한다. 먼저 monocular depth estimation으로 입력 이미지의 geometry를 추정하고, depth와 camera parameter를 이용해 input view에서 target view까지의 2D motion trajectory를 생성하여 motion condition으로 사용한다. Table 2에서 DepthSplat, ViewCrafter, SEVA와 비교했을 때 MotionStream은 전용 3D novel-view synthesis model이 아님에도 PSNR, SSIM, LPIPS에서 높은 성능을 보이며, 특히 causal model은 기존 baseline과 bidirectional teacher보다 훨씬 높은 throughput을 유지한다.
Ablation Experiments
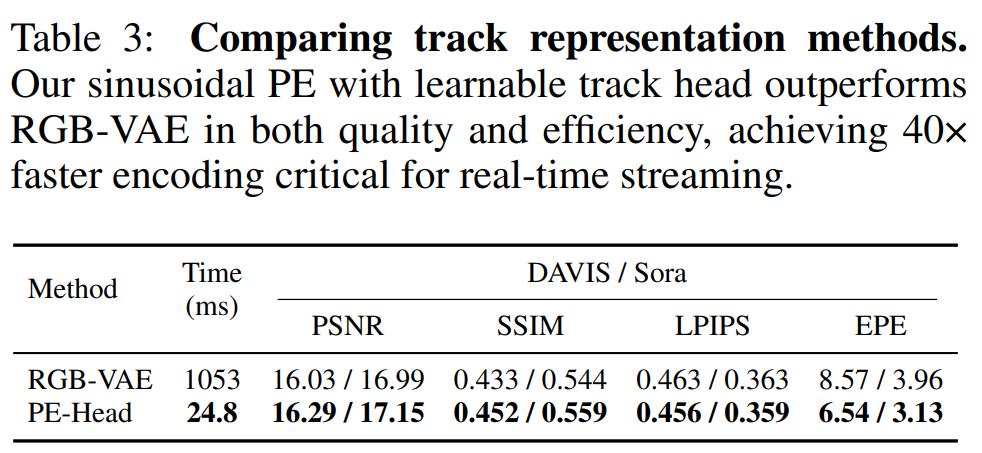
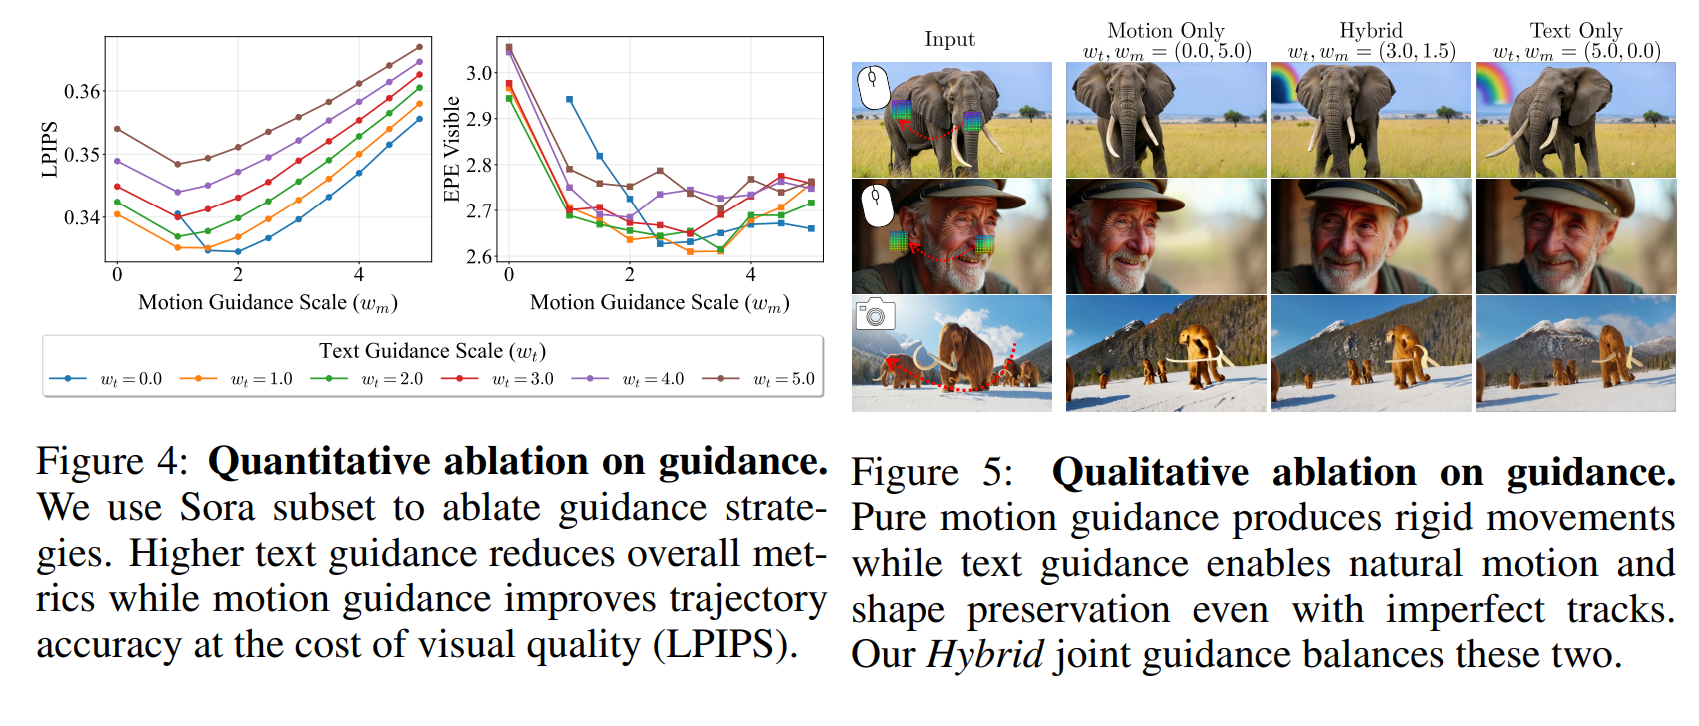
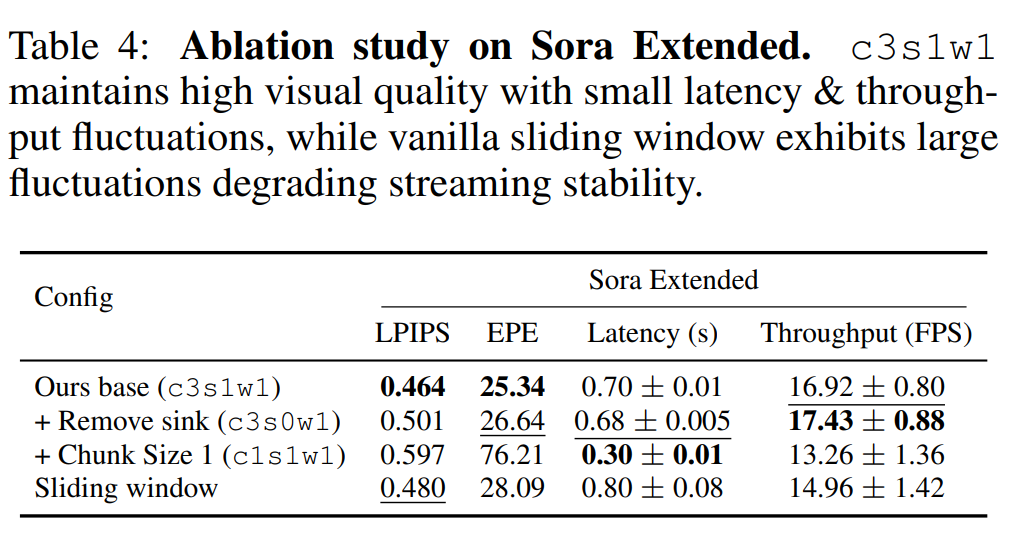
Ablation에서는 크게 track representation, text-motion guidance, chunk/sink/window 설계를 분석한다. 먼저 Table 3에서는 기존 RGB-VAE 기반 trajectory encoding과 제안한 sinusoidal positional encoding + learnable track head를 비교한다. 제안 방식은 VAE를 거치지 않아 encoding 시간이 크게 줄면서도 motion alignment와 video quality가 더 좋아, real-time streaming에 더 적합함을 보인다. 이어 Figure 4, Figure 5에서는 text guidance와 motion guidance의 균형을 분석한다. Motion guidance가 강하면 trajectory adherence는 좋아지지만 motion이 rigid해지고 visual quality가 저하될 수 있으며, text guidance는 더 자연스럽고 풍부한 dynamics를 생성하지만 trajectory 정확도가 떨어질 수 있다. 따라서 논문은 $w_t=3.0, w_m=1.5$의 joint guidance를 사용해 두 특성의 균형을 맞춘다.
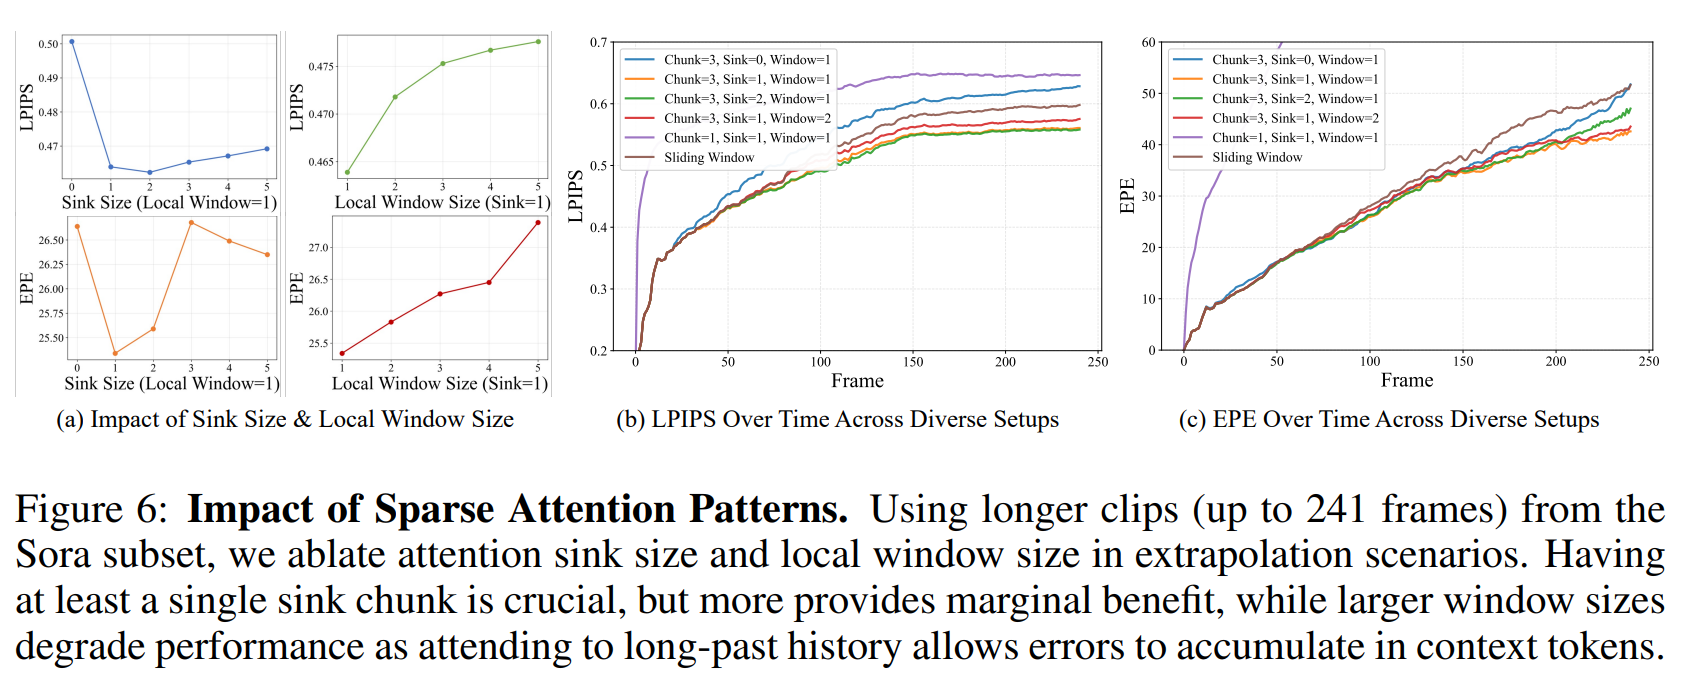
또한 long-video streaming을 위한 chunk size, attention sink size, local window size를 분석한다. Table 4와 Figure 6에서 chunk size는 너무 작으면 autoregressive rollout이 많아져 품질과 throughput이 떨어지고, 너무 크면 latency가 커지는 trade-off를 보이며, 최종적으로 chunk size 3을 선택한다. Attention sink는 최소 1개만 있어도 long-term drift 억제에 크게 기여하며, sink 수를 더 늘려도 이득은 크지 않다. 반대로 local window를 크게 하면 오래된 self-generated context까지 참조하면서 error accumulation이 커져 오히려 성능이 나빠진다. 이에 따라 최종 설정으로 c3s1w1 (chunk 3, sink 1, window 1)을 채택하며, 이는 긴 영상에서도 품질을 안정적으로 유지하면서 latency와 throughput 변동도 작게 만든다.
Streaming Demo and Qualitative Results
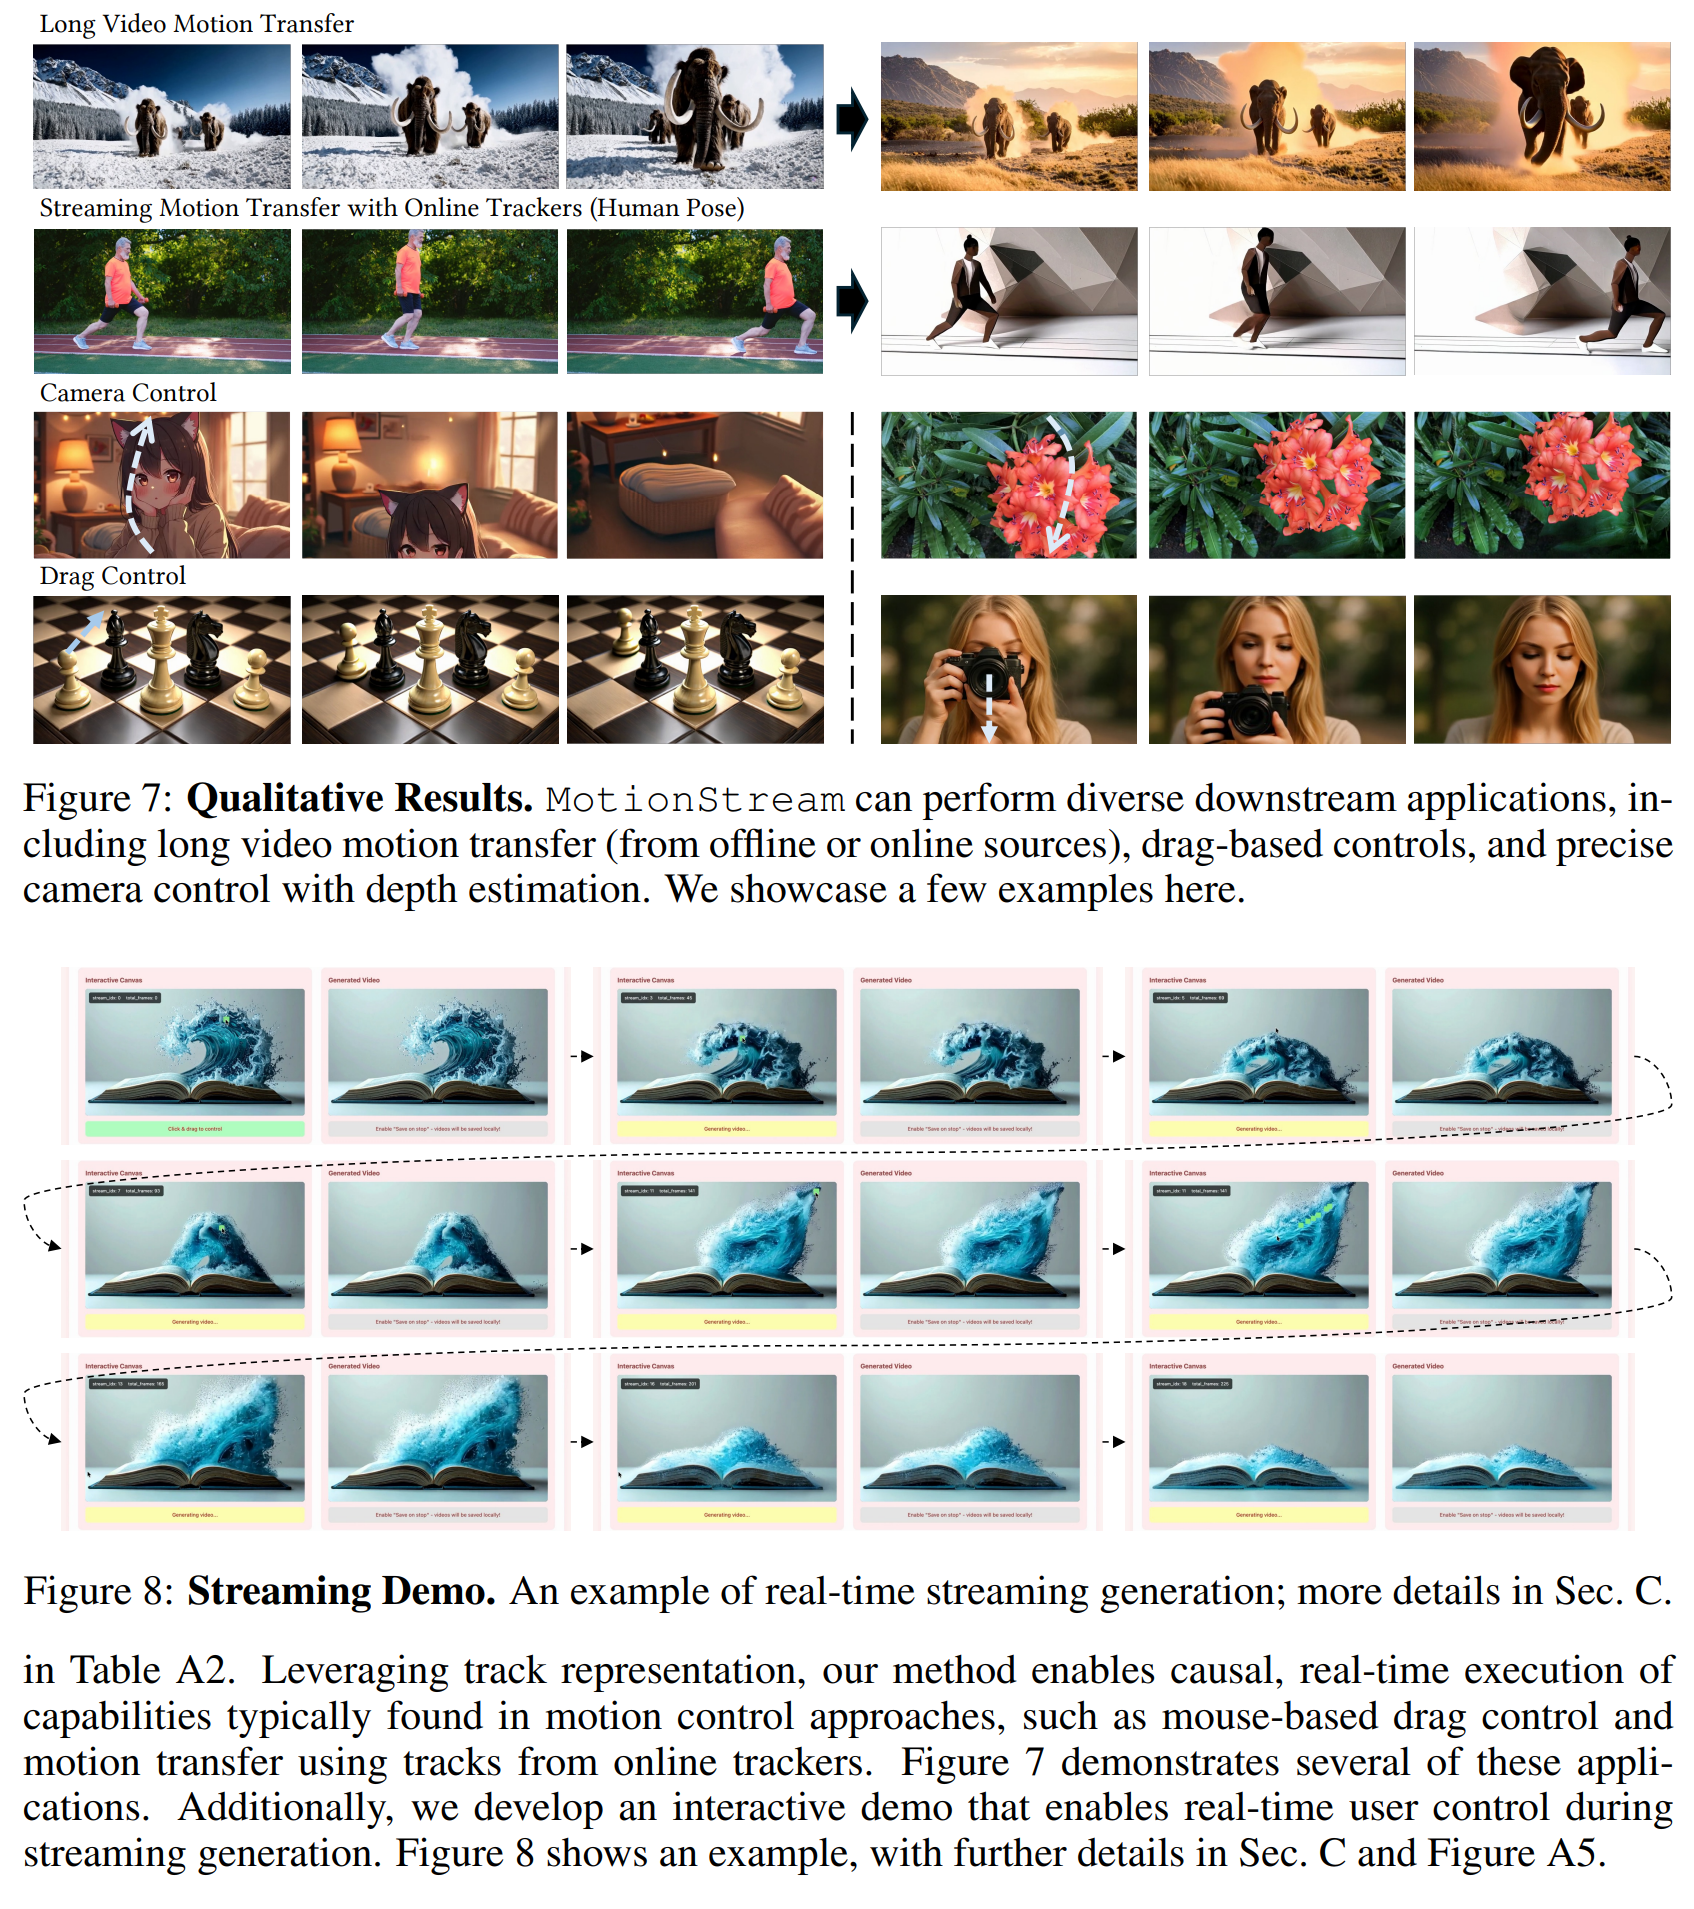
실시간 streaming을 위해 기존 VAE decoding bottleneck을 줄이는 Tiny VAE decoder를 추가로 학습한다. 이를 통해 Wan 2.1 기반 모델은 16.7 FPS / 0.69s latency → 29.5 FPS / 0.39s latency, Wan 2.2 기반 모델은 10.4 FPS / 1.1s → 23.9 FPS / 0.49s로 크게 가속된다. Figure 7에서는 long-video motion transfer, drag-based control, camera control 등 다양한 적용 사례를 보여주며, Figure 8에서는 사용자가 생성 중 trajectory를 실시간으로 조작할 수 있는 interactive streaming demo를 제시한다.
Limitations & Future Work
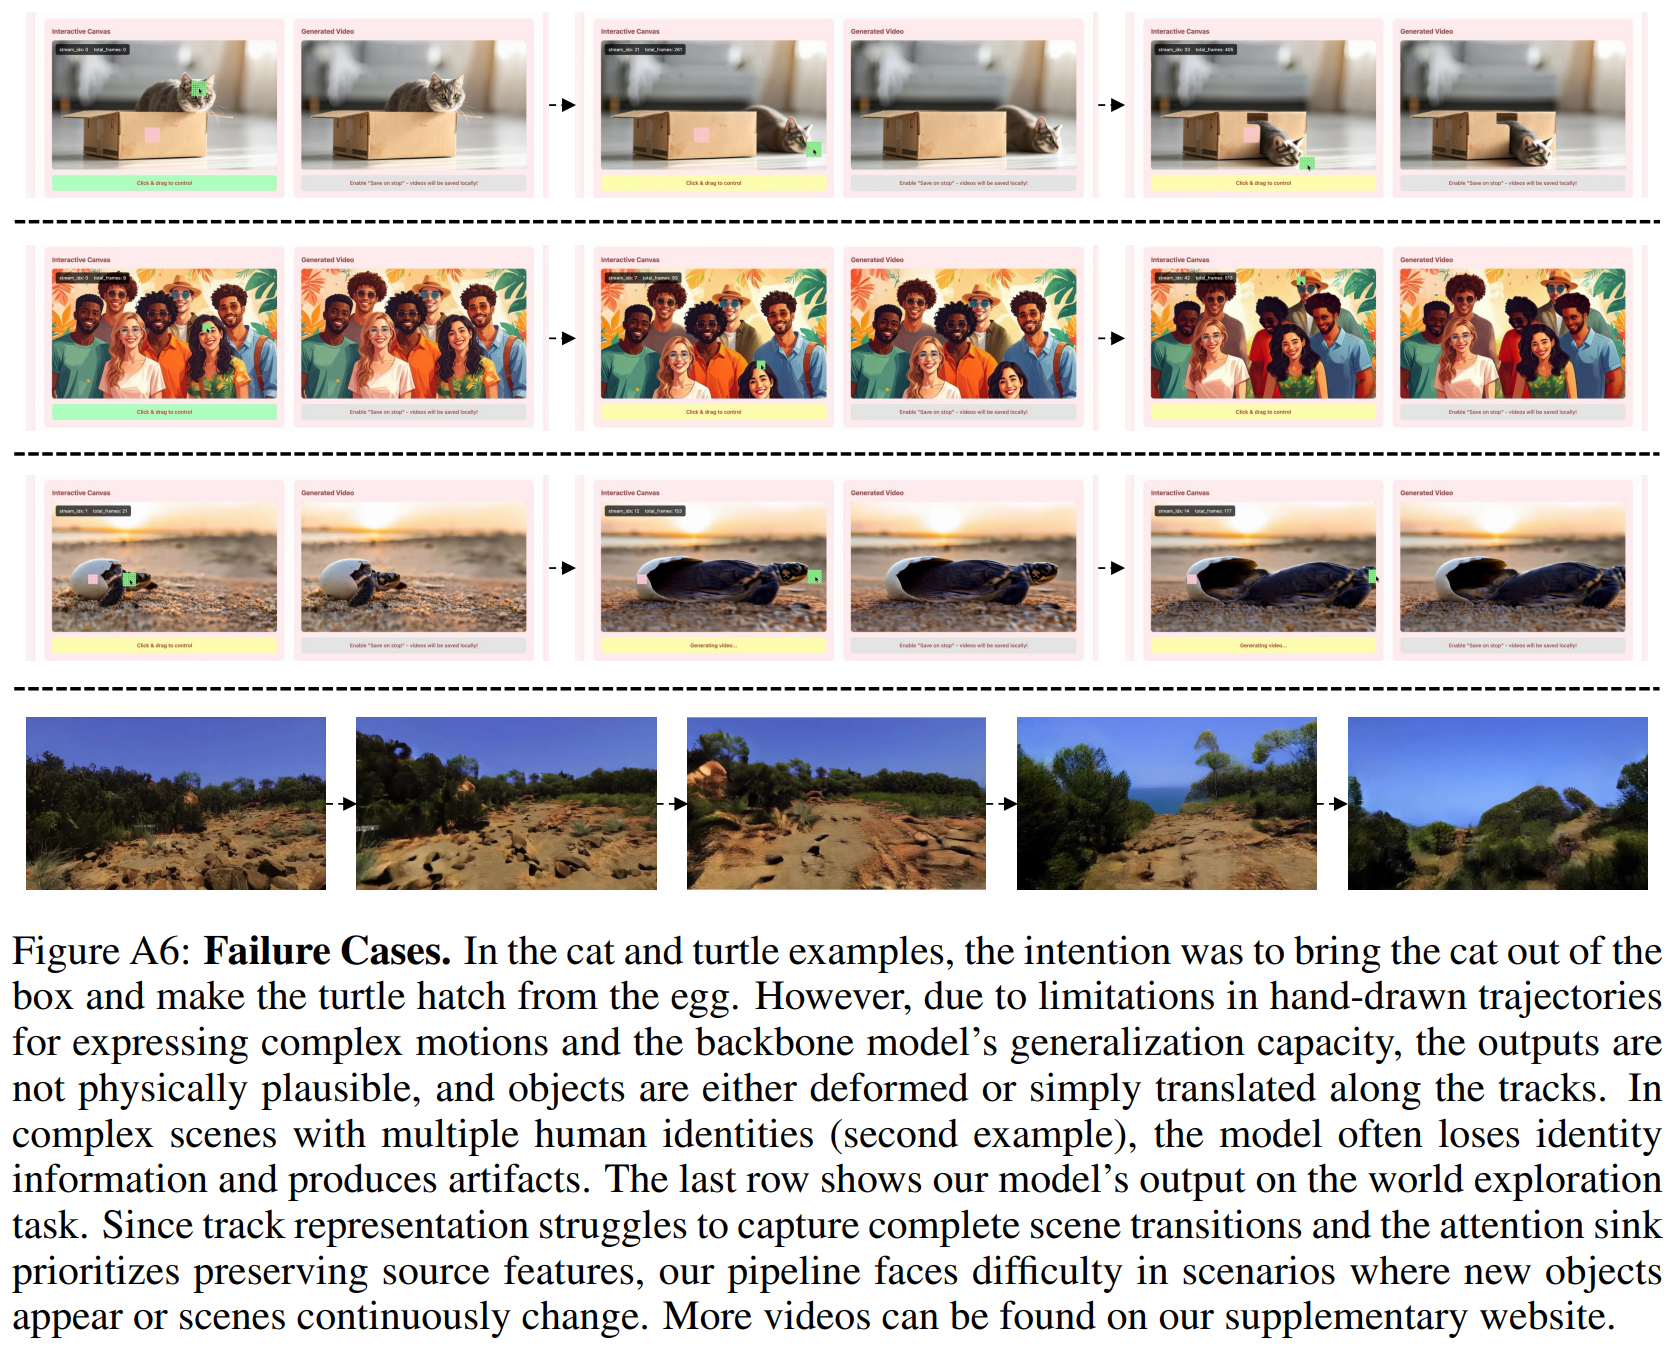
- fixed attention sink가 초기 장면에 강하게 anchor되기 때문에 장면이 완전히 바뀌는 long-term world exploration에는 부적합하다. 그래서 dynamic attention sink / anchor refresh를 future work로 제안한다.
- 너무 빠르거나 물리적으로 비현실적인 trajectory에서는 temporal inconsistency나 object deformation이 발생할 수 있어, 더 다양한 track augmentation과 larger backbone 활용이 필요하다고 한다.
- 복잡한 scene, text, motion에서는 source detail과 identity 유지가 어려울 수 있으며, 이는 backbone capacity와 image-conditioning 방식의 한계와 관련되어 있다.