[Paper Review, KR] Turbo3D: Ultra-fast Text-to-3D Generation
Paper Information
Title: Turbo3D: Ultra-fast Text-to-3D Generation
Authors: Hanzhe Hu, Tianwei Yin, Fujun Luan, Yiwei Hu, Hao Tan, Zexiang Xu, Sai Bi, Shubham Tulsiani, Kai Zhang
Venue: CVPR 2025
Link: [Paper], [Project], [GitHub]
Teaser Image
Introduction
기존 text-to-image 분야에서 diffusion model을 기반으로 one-step/few-step generation이나 diffusion distillation 같은 기법을 통해 추론 속도가 크게 개선되었다. 반면 이러한 발전은 3D generation에서는 충분히 이어지지 못했다.
기존 text-to-3D 방법은 크게 optimization-based 방식과 generative 방식으로 나뉘는데, optimization-based 방법은 pretrained 2D diffusion model의 prior을 distillation하여 3D representation을 최적화하기 때문에 비교적 좋은 품질을 얻을 수 있지만, 하나의 3D asset을 생성하는 수분에서 수시간까지 걸리는 높은 추론 비용이 문제가 된다.
한편 초기 generative 방법들은 point cloud나 SDF와 같은 3D representation을 직접 생성하려 했지만, 학습에 사용할 수 있는 고품질 3D 데이터가 제한적이어서 생성 품질과 generalization에 한계가 있다.
이를 보완하기 위해 최근에는 먼저 text-conditioned multi-view image를 생성한 뒤 이를 3D로 reconstruction하는 방식이 많이 사용되고 있으나 multi-view diffusion model을 synthetic 3D 데이터로 fine-tuning 하면서 이미지 품질이 저하될 수 있으며, 특히 여러 번의 iterative denoising이 필요한 diffusion sampling 때문에 전체 text-to-3D pipeline의 속도가 여전히 제한된다.
또한 기존 diffusion distillation 연구들은 주로 2D image generation에 집중되어 있어, multi-view diffusion에 그대로 적용할 경우 fine-tuning과 distillation이 연속적으로 diversity를 줄이면서 mode collapse가 더 심해질 수 있다는 문제가 존재한다.
Method & Technical Details
Background
논문의 저자들은 논문의 방법론을 설명하기 전에 필요한 배경 지식에 대해 설명한다.
Multi-view Diffusion model
먼저 저자들은 Multi-view Diffusion Model에 대해서 설명한다.
일반적인 diffusion model에서는 clean sample $x_0$에 점점 Gaussian noise를 추가해서 $x_t$를 만들고, 모델이 이 noise를 역으로 제거하도록 학습한다. 논문에서는 forward noising process를 다음처럼 정의한다:
\[q(x_t | x_0) = \mathcal{N}(x_t; \alpha_t x_0, \sigma_t^2 I)\]여기서 $\alpha_t$는 원본 signal이 얼마나 남아 있는지, $\sigma_t$의 경우는 noise의 크기를 의미한다. 그리고 모델 $\epsilon_{\theta}$는 $x_t$와 timestep $t$를 입력으로 받아서, 원래 추가되었던 noise $\epsilon$를 예측하도록 학습된다.
\[\mathcal{L} (\theta) = \mathbb{E}[\lVert \epsilon - \epsilon_{\theta}(x_t, t) \rVert^2]\]즉 일반적인 noise-prediction diffusion 학습 방식이다. 논문에서는 $x_0$를 직접 예측하거나 velocity 형태로 예측하는 다른 parameterization도 가능하지만, Turbo3D에서는 noise prediction formulation을 사용한다고 말한다.
또한 이런 prediction 결과는 결국 data distribution의 score function
\[s_{\theta}(x_t, t) = \nabla_{x_t} log \; p(x_t)\]과 연결될 수 있다고 설명한다.
일반 diffusion에서는 하나의 image $x$를 denoising하지만, multi-view diffusion에서는 동일한 3D object를 바라보는 여러 view를 동시에 denoising한다.
논문에서는
\[\{x^i\}_{i=1}^K\]라는 $K$ 개의 multi-view image를 사용한다.
여기서 중요한 점은 multi-view의 각 시점을 독립적으로 생성하는 게 아니라 하나의 모델에서 함께 denoising 하는 것이다.
그래서 논문의 training objective도 아래의 형태로 제시된다:
\[\mathbb{E}[\lVert \epsilon - \epsilon_{\theta}(\{x^i\}_{i=1}^K, t, c) \rVert^2]\]여기서 $c$는 text prompt다. 중요한 점은 각 view에 서로 독립적으로 Gaussian noise가 추가되지만, 모델은 이 view들을 동시에 입력받아서 noise를 예측한다는 것이다.
그래서 각 view가 제각각 생성되는 것이 아니라, 가능한 한 동일한 3D object를 나타내도록 multi-view consistency를 학습하게 된다.
Distribution Matching Distillation(DMD)
이 논문에서는 DMD를 많은 denoising step이 필요한 diffusion teacher를, 훨씬 적은 step으로 생성하는 student로 distillation하는 방법으로 설명한다.
애초에 해당 기법의 경우에는 이전 논문들에 리뷰한 적이 많다.
핵심은 student generator $G_{\theta}$가 만드는 분포 $p_{fake}$를 실제 데이터 분포에 가까운 $p_{real}$과 맞추는 것이다.
이를 reverse KL divergence로 표현한다:
\[L_{DMD}(\theta) = D_{KL}(p_{fake} || p_{real})\]논문에서는 이를
\[L_{DMD}(\theta) = \mathbb{E}_{x,t} [log \frac{p_{fake}(x_t)} {p_{real}(x_t)}]\]로 표현한다. 즉, student가 생성하는 distribution인 $p_{fake}$를 DMD를 통해 Teacher/Data distribution인 $p_{real}$쪽으로 이동시키는 것이 목표다.
어떻게 distribution 자체를 비교하는 지도 중요하다.
$p_{real}(x)$ 나 $p_{fake}(x)$의 probability density를 직접 계산하는 것은 어렵기 때문에, DMD는 대신 각각의 score function을 사용한다.
\[\begin{aligned} s_{real}(x_t, t)&= \nabla_{x_t} log \; p_{real} (x_t) \\ s_{fake} (x_t, t)&= \nabla_{x_t} log \; p_{fake} (x_t) \end{aligned}\]그리고 reverse KL의 gradient를 이 두 score의 차이로 근사한다.
\[\nabla_{\theta} L_{\mathrm{DMD}}(\theta) \approx \mathbb{E}_{z,t} \left[ -w_t \left( s_{\mathrm{real}} \left( F(G_{\theta}(z), t), t \right) - s_{\mathrm{fake}} \left( F(G_{\theta}(z), t), t \right) \right) \frac{dG_{\theta}(z)}{d\theta} \right]\]정확히는 student가 생성한 결과에 forward diffusion $F(\cdot, t)$를 적용한 noisy sample에서 두 score를 평가한다.
해당 score difference를 통해서 student $G_{\theta}$를 업데이트한다.
추가적으로, 기본적인 one-step DMD를 생각하면, student $G_{\theta}$는 처음부터 완전한 Gaussian noise를 입력받아서 한 번에 결과를 만든다고 생각할 수 있다:
\[\epsilon \rightarrow G_{\theta} \rightarrow x_0\]그런데 Turbo3D는 4-step generator를 만들려고 한다. 그러면 student가 항상 완전한 noise에서 clean image까지 한 번에 갈 필요 없이 diffusion 과정 중간의 noisy sample인 $x_t$를 입력으로 받아서, 그것보다 더 깨끗한 상태를 예측하도록 만들 수 있다.
이 이후부터는 논문이 제안하는 방법론들에 대해서 설명한다.
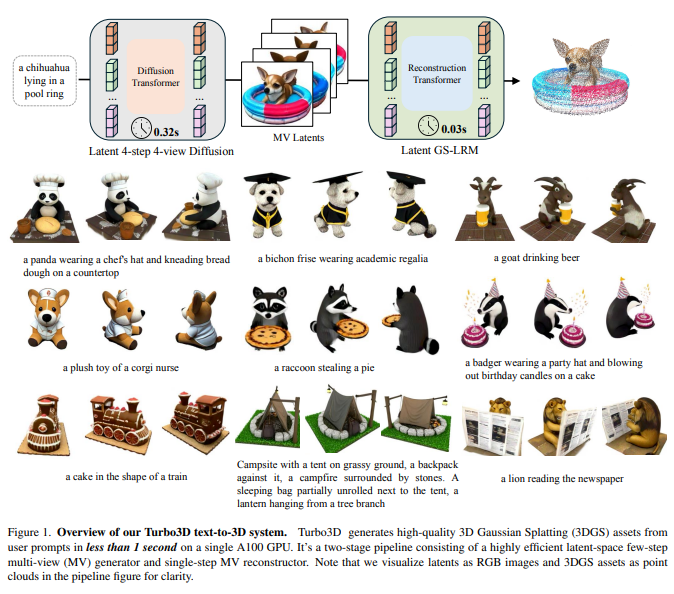
Turbo3D의 파이프라인은 크게 두 부분으로 구성된다. Few-step Multi-view Generator와 Multi-view Reconstructor다. Few-step Multi-view Generator의 경우 Dual-teacher Distillation으로 학습을 진행하고, Multi-view Reconstructor는 Latent GS-LRM으로 진행한다.
Dual-teacher Distillation for MV Diffusion
먼저, Turbo3D는 기존 multi-view diffusion model이 느린 것에 대해 말한다. text prompt를 받아 여러 view를 생성할 때, denoiser를 여러 번 실행해야 하기 때문에 text-to-3D pipeline에서 MV generation 부분 자체가 상당히 느려진다는 것이다.
이를 줄이기 위해 앞서 설명한 DMD/DMD2 같은 diffusion distillation을 사용해서 many-step MV diffusion을 single-step 또는 few-step MV generator로 바꾸는 것을 제안한다.
그런데 MV Teacher 하나로만 distillation을 하자니 문제가 생긴다. 저자들은
MV teacher만 가지고 student를 DMD distillation 했더니, student가 생성하는 결과가 너무 단순하고 cartoon-like한 모습으로 변한다.
라는 것을 발견했다.
특히 결과가 MV teacher를 fine-tuning하는 데 사용했던 Objaverse의 synthetic 3D asset 스타일에 매우 가까워진다고 설명한다.
저자들은 이 현상을 compounding mode collapse라고 부른다. 이는 mode collapse가 한 번이 아니라 두 단계에 걸쳐 누적되기 때문에 compounding이라고 한다.
이 compounding mode collapse의 과정을 보여주면, 처음에는 강력한 text-to-image 모델을 가지고 있다고 가정하자. 원래 이 모델은 인터넷 규모의 큰 스케일 image data를 통해 넓은 distribution을 학습한 상태다.
그런데 이를 Objaverse의 multi-view data로 fine-tuning하면:
\[p_{original} \rightarrow p_{\text{MV teacher}}\]가 되면서 distribution이 Objaverse 쪽으로 좁아진다. 즉 이미 첫 번째 diversity 감소가 일어난다.
그 MV teacher를 다시 few-step student로 distillation하면
\[P_{text{MV teacher}} \rightarrow p_{student}\]과정에서 또 한 번 diversity가 줄어들 수 있다. 그래서 결국 synthetic Objaverse mode로 두 번 압축되는 효과가 나타난다.
이제 Turbo3D가 이를 어떻게 해결하는지 보자. Turbo3D는 teacher를 하나 더 넣는 방식을 사용한다.
기존에는 MV teacher만 사용하던 것을 SV teacher라는 single-view teacher를 투입한다. 먼저 MV teacher의 경우는 Multi-view consistency를 가르친다. 예를 들어, 4개의 view가 있다면,
\[\{x^1, x^2, x^3, x^4\}\]를 하나의 set으로 함께 보고 이 네 장이 동일한 3D object의 서로 다른 view처럼 보이는지 판단하는 역할을 수행한다. SV teacher의 경우에는 각각의 view를 독립적으로 본다.
\[x_1, x_2, x_3, x_4\]각각에 대해 이 한 장의 이미지 자체가 자연스럽고 photorealistic한지에 대해 가르친다.
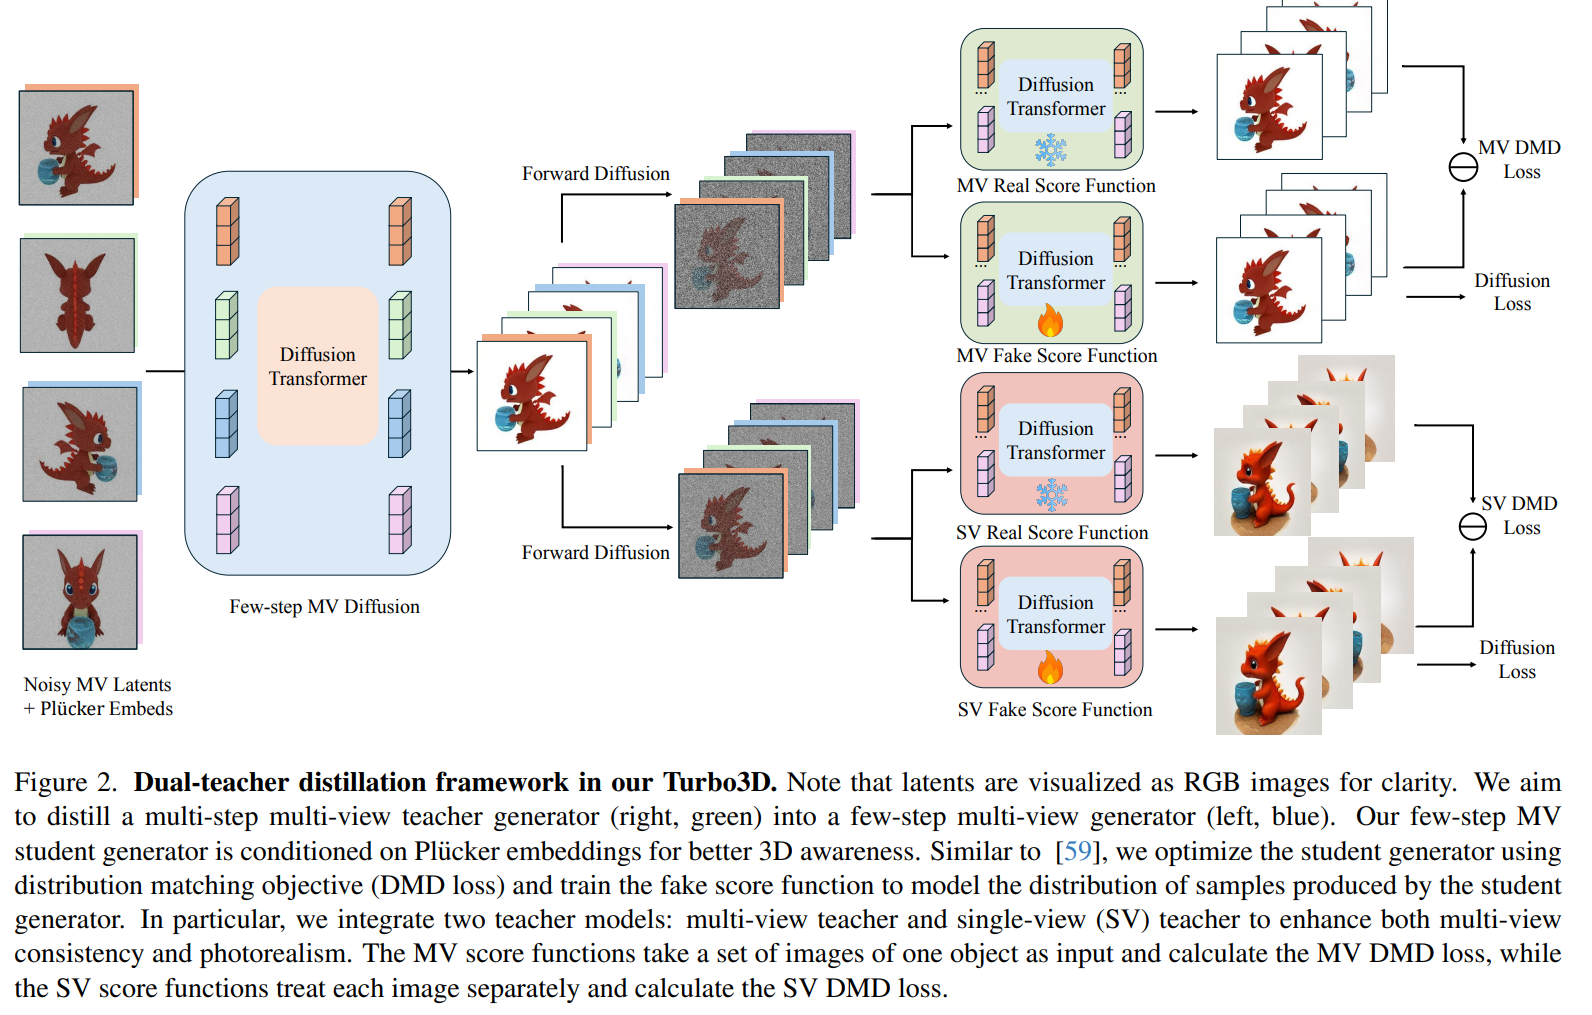
Fig. 2를 보면 왼쪽의 blue block이 few-step MV student diffusion model이다. Student의 입력은 noisy, MV latents, Plücker embeddings 이고, Diffusion Transformer를 통해 여러 view의 latent를 생성한다.
논문은 Plücker embeddings를 student에 condition해서 3D awareness를 높인다라고 설명한다.
생성된 4개의 view를 예를 들어
\[\{x^1, x^2, x^3, x^4\}\]라고 하자. 여기에 random timestep $t$의 forward diffusion을 적용해서
\[\{x_t^1, x_t^2, x_t^3, x_t^4\}\]를 만들고, Fig. 2를 보면 알겠지만 이것을 두 경로로 동시에 보낸다. 위쪽 경로의 경우에는 Multi-view DMD에 해당한다.
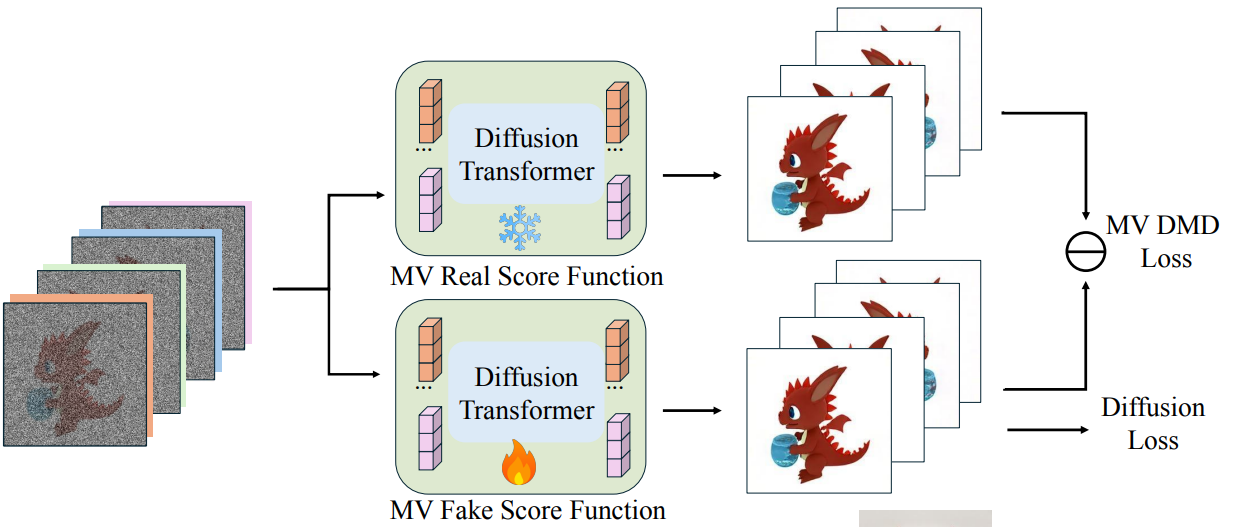
여기서는 네 view를 set 전체로 입력한다. MV teacher의 real score와 현재 student distribution의 fake score를 비교해서 DMD loss를 계산한다. 즉 목표는
\[p_{fake} \rightarrow p_{real}^{MV}\]
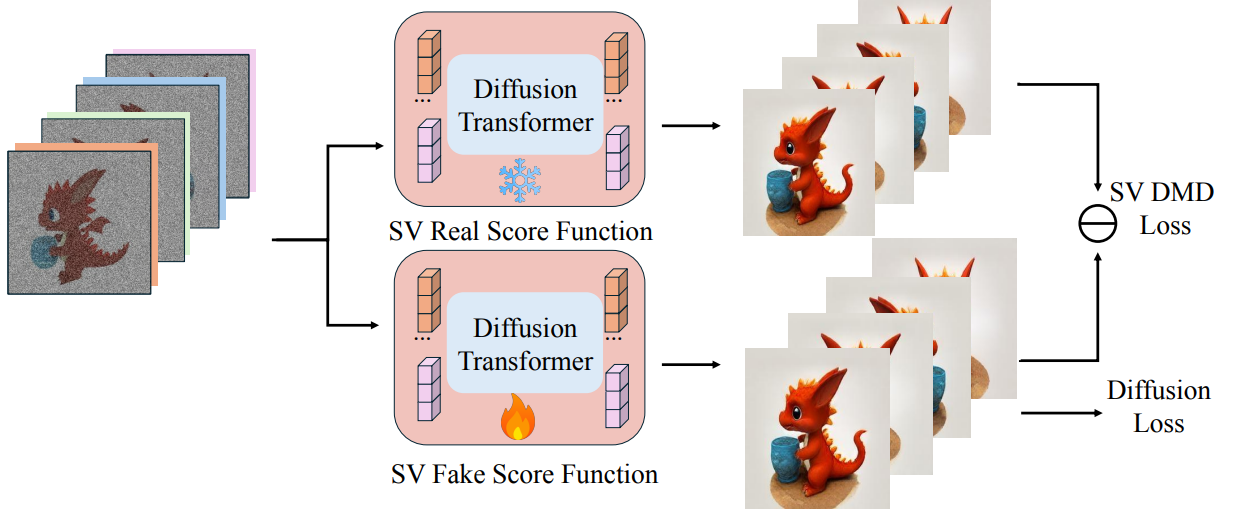
아래쪽 경로에서는 multi-view sample을 view별로 분리한다. 각 이미지마다 SV teacher의 distribution과 비교한다. 즉 각각
\[p_{fake}(x_t^i) \rightarrow p_{real}^{SV}(x_t^i)\]MV score function은 한 object의 image set 전체를 입력받지만, SV score function은 각 image를 따로 처리한다고 설명한다.
논문의 Dual-teacher DMD objective는 다음과 같다.
\[L_{\mathrm{DMD}}^{\mathrm{Dual}}(\theta) = D_{\mathrm{KL}} \left( p_{\mathrm{fake}} \left( \{x_t^i\}_{i=1}^{K} \right) \parallel p_{\mathrm{real}}^{\mathrm{MV}} \left( \{x_t^i\}_{i=1}^{K} \right) \right) + \lambda \cdot \frac{1}{K} \sum_{i=1}^{K} D_{\mathrm{KL}} \left( p_{\mathrm{fake}}(x_t^i) \parallel p_{\mathrm{real}}^{\mathrm{SV}}(x_t^i) \right)\]사실 이 식은 두 개의 DMD를 그냥 더한 것으로 이해하면 된다.
첫 번째 항에서 중요한 것은 ${x_t^i}_{i=1}^K$ 전체가 들어간다는 점이다. 즉
\[(x_t^1, x_t^2, x_t^3, x_t^4)\]의 joint distribution을 MV teacher와 맞춘다.
두 번째 항은 각 view $i$에 대해 독립적으로 SV teacher와 distribution matching을 수행하고,
\[\frac{1}{K} \sum_{i=1}^K\]으로 모든 view의 loss를 평균낸다. Turbo3D에서는 $K=4$이고, $\lambda = 1$로 설정한다. 즉 MV와 SV teacher의 영향을 동일한 loss weight로 사용한다.
그래서 loss를 직관적으로 쓰면
\[L_{Dual} = L_{\text{MV-consistency}} + \lambda L_{photorealism}\]이라고 이해할 수 있다.
Latent GS-LRM for MV Reconstruction
기존의 가장 단순한 방식은 multi-view diffusion이 만든 latent를 먼저 VAE decoder로 RGB image로 복원한 다음, pixel-space GS-LRM에 넣는 방식이다.
그런데 저자들은 이 과정에서 VAE decoding 자체가 불필요한 overhead라고 본다. 특히 high-resolution에서 VAE decoder의 Conv2D 연산이 속도와 메모리 측면에서 비효율적일 수 있다고 지적한다.
즉 multi-view generator가 이미 latent를 잘 만들어놨는데, 굳이 한 번 RGB로 풀었다가 다시 reconstruction model에 넣는 건 비효율적이라는 의미다.
그래서 Turbo3D는
\[\text{MV Latents} \rightarrow \text{Latent GS-LRM} \rightarrow \text{3D Gaussians}\]로 바로 연결한다. 논문에서는 이 latent-space reconstructor를 Latent GS-LRM이라고 부르고, generated MV latents를 직접 입력으로 받아 3D Gaussian을 예측하도록 학습한다.
여기서 중요한 점은 학습 supervision은 여전히 pixel-space novel-view rendering loss를 쓴다는 점이다.
즉, Latent GS-LRM이 latent를 입력으로 받더라도 최종적으로 예측한 3D Gaussian을 novel view에서 렌더링 한 뒤, L2 loss와 perceptual loss를 사용해 supervision한다고 설명한다.
Experiments
Setup
학습에는 Objaverse라는 데이터셋을 사용한다. Multi-view generation을 위해 객체를 $[-1, 1]^3$ 범위로 정규화한 뒤 elevation $20 \degree$, 16개 azimuth를 렌더링하고, reconstruction 학습에는 객체 주변의 32개 random view를 사용하며 총 730K objects를 렌더링한다.
Baseline으로는 Instant3D, LGM, TripoSR, SV3D를 사용하고, 평가는 DreamFusion의 400개 prompt에 대해 각 생성 객체의 10개 random view를 렌더링하여 CLIP score, VQA score, inference time을 측정한다.
전체 학습은 multi-step MV diffusion 학습, few-step MV generator distillation, Latent GS-LRM 학습으로 진행된다. 학습 iteration 동안 32장의 80GB A100 GPU를 사용한다.
Evaluation against baselines
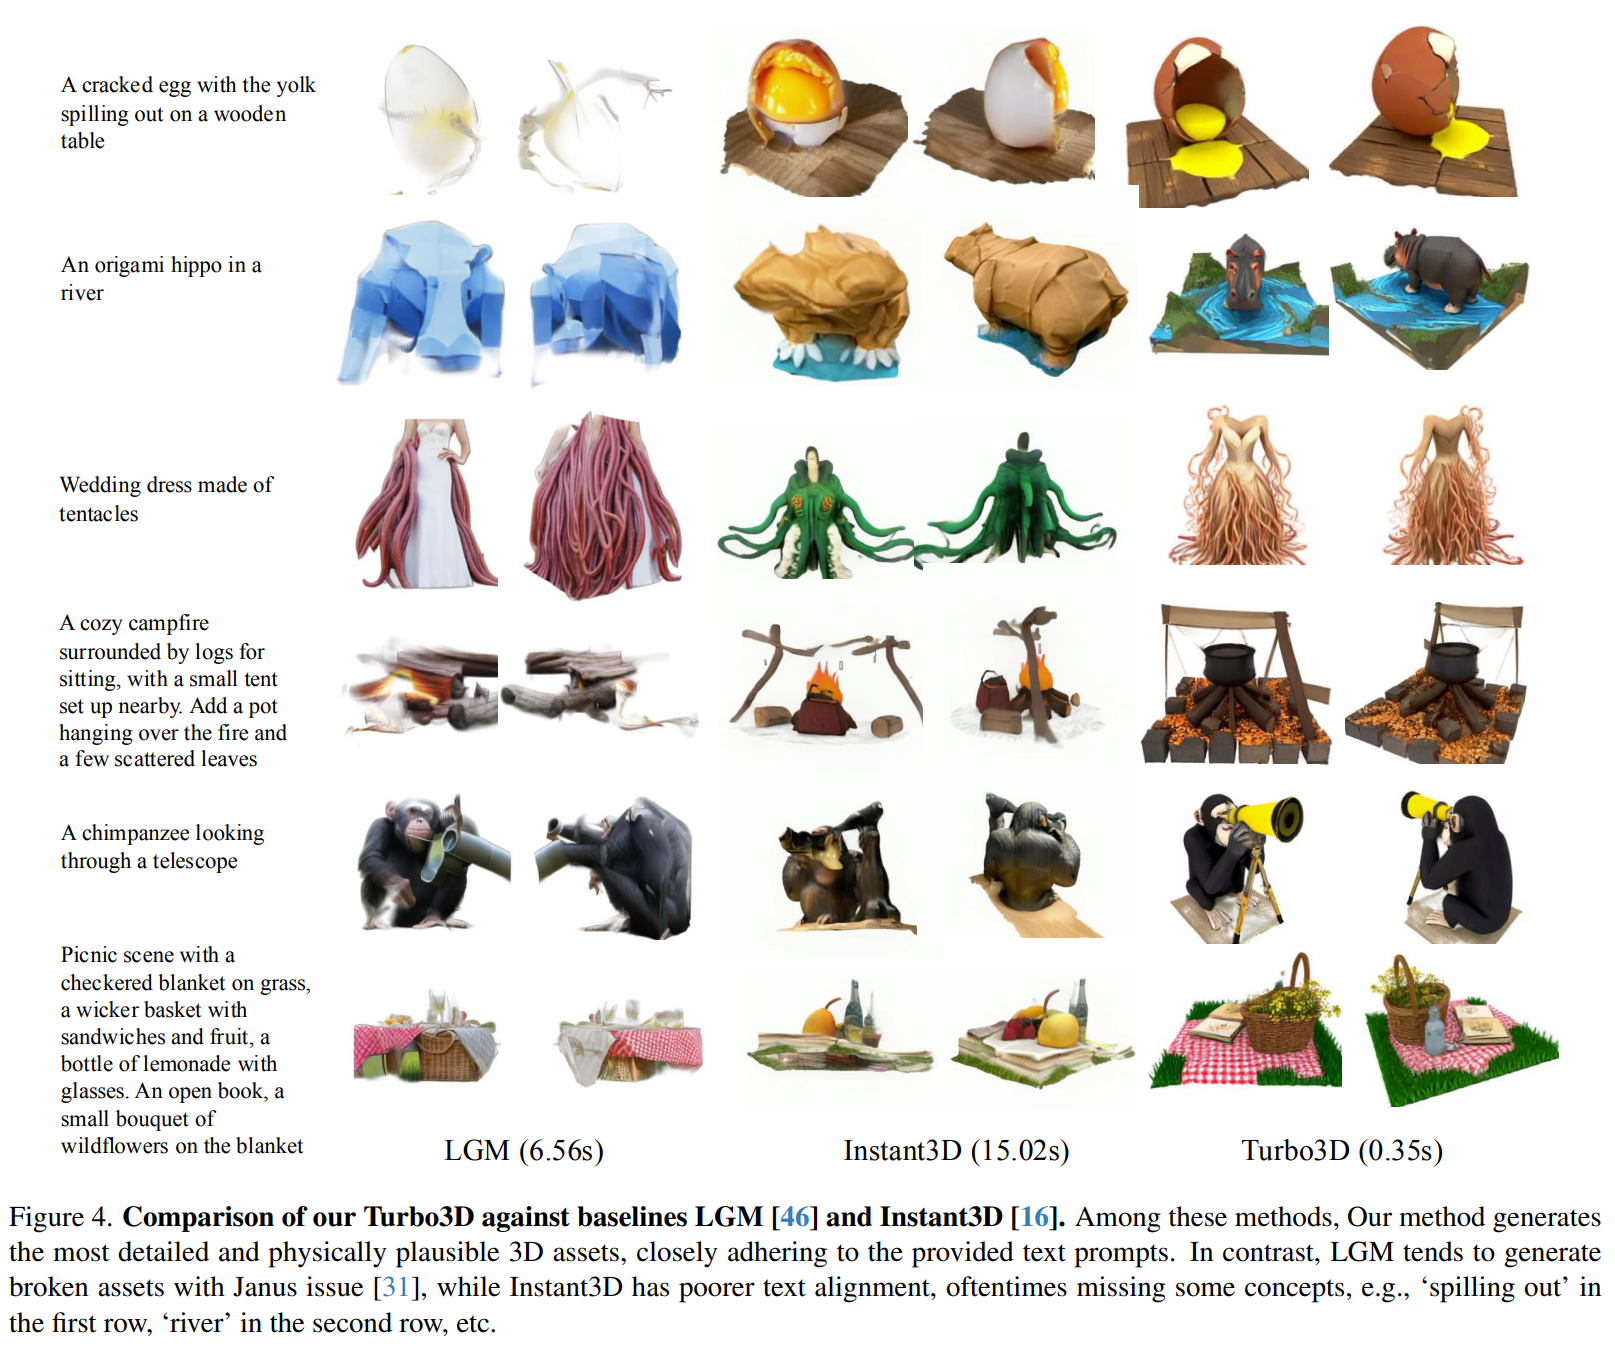
Figure 4에서 LGM은 단순하거나 깨진 3D asset, Janus problem, 낮은 text alignment 문제가 자주 나타나고, Instant3D는 더 안정적이지만 복잡한 prompt의 세부 개념이나 texture를 충분히 반영하지 못하는 경우가 있다고 설명한다. 반면 Turbo3D는 복잡한 prompt에서도 더 세밀하고 물리적으로 그럴듯하며 text alignment가 높은 결과를 보인다고 주장한다.
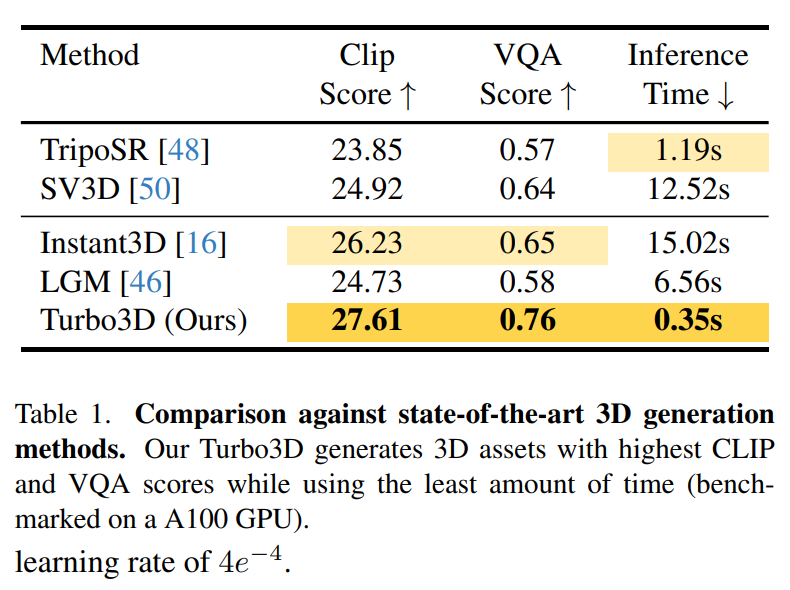
Table 1에서 Turbo3D가 비교 방법들보다 높은 품질 지표와 짧은 생성 시간을 보인다.
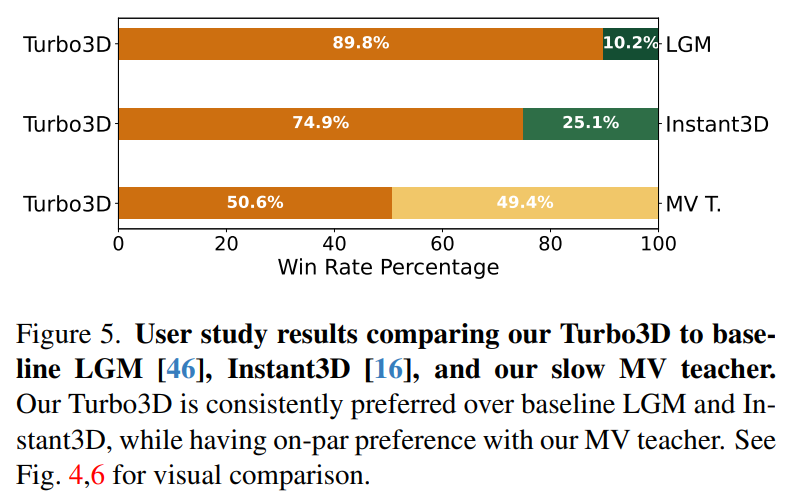
Figure 5의 user study에서는 56명의 사용자가 80개 prompt에 대해 1120회의 pairwise comparison을 수행했으며, Turbo3D는 LGM과 Instant3D보다 더 자주 선호되고, 자신의 MV teacher와는 거의 비슷한 수준의 선호도를 보였다고 보고한다.
Ablation study
여기서는 Turbo3D의 핵심 구성 요소인 Dual-teacher Distillation과 Latent GS-LRM의 효과를 검증한다.
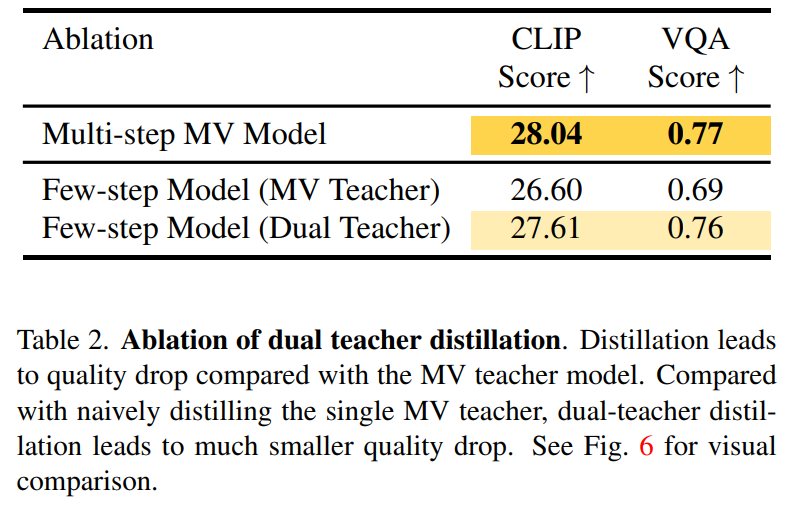
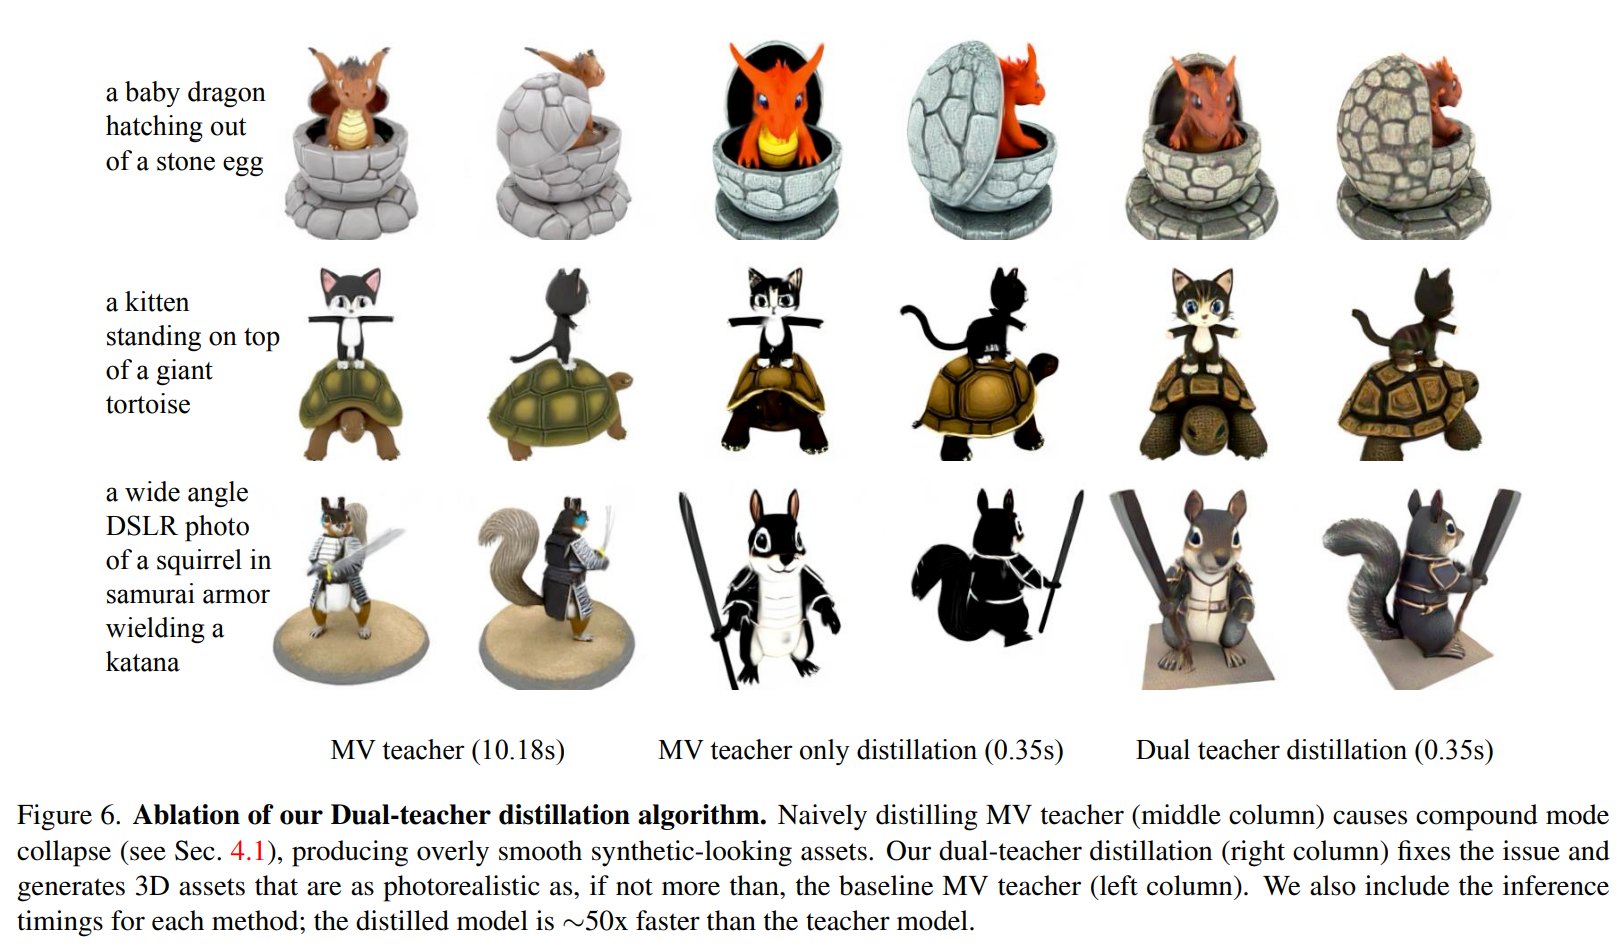
먼저 Table 2와 Figure 6에서 multi-step MV teacher를 MV teacher를 하나만 사용해 few-step으로 distillation하면 CLIP/VQA에 크게 하락하고, 결과도 지나치게 smooth하고 synthetic하게 변하는 compounding mode collapse가 나타난다.
반면 SV teacher를 추가한 dual-teacher distillation은 few-step의 빠른 속도를 유지하면서도 MV teacher와 거의 비슷한 품질까지 회복한다.
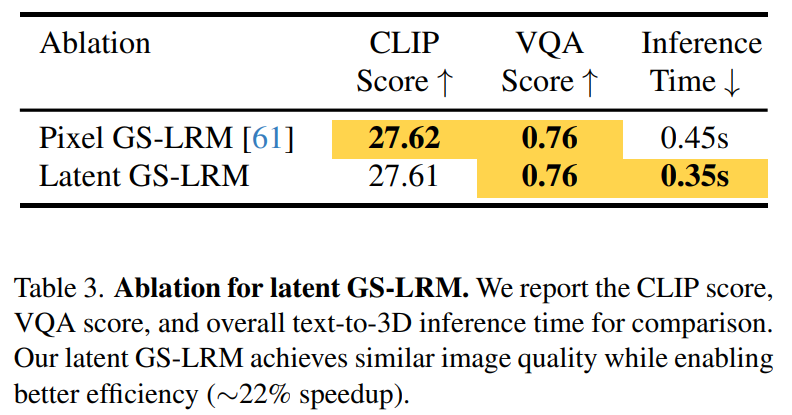
Table 3에서는 기존 Pixel GS-LRM과 Latent GS-LRM을 비교하며, Latent GS-LRM이 VAE decoding을 생략해 전체 inference time을 줄이면서도 CLIP/VQA 품질은 거의 동일하게 유지함을 보여준다.
Contributions
- 1초 이하로 3DGS asset을 생성하는 시스템을 제안한다.
- MV teacher로 multi-view consistency를 학습하고 SV teacher로 photorealism을 보완하는 dual-teacher distillation 방식을 제안한다.
- latent를 직접 GS-LRM에 입력해 3D Gaussian을 reconstruction 하는 방식을 제안한다.
Limitations & Future work
- 가장 먼저 학습 데이터의 제약이 보인다. 일단 실험 자체가 object-centric에 머물러 있어 scene scale까지 확장되어 있는 수준이 아니다.
- 실제 3D asset의 geometry accuracy, surface completeness, multi-view consistency를 정교하게 측정하는 3D metric은 상대적으로 약하다.