[Paper Review, KR] SparseCam4D: Spatio-Temporally Consistent 4D Reconstruction from Sparse Cameras
Paper Information
Title: SparseCam4D: Spatio-Temporally Consistent 4D Reconstruction from Sparse Cameras
Authors: Weihong Pan, Xiaoyu Zhang, Zhuang Zhang, Zhichao Ye, Nan Wang, Haomin Liu, Guofeng Zhang
Venue: CVPR 2026
Link: [Paper], [Project], [GitHub]
Teaser Image
Introduction
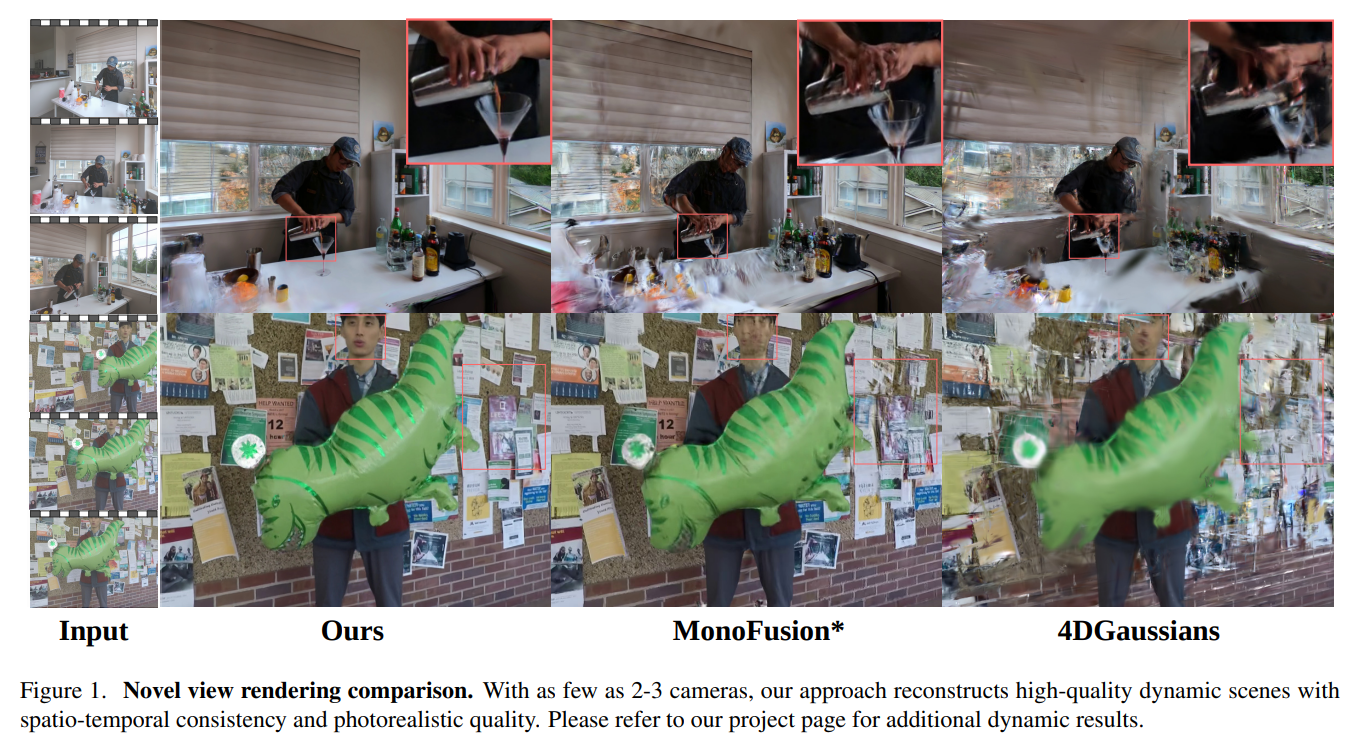
동적 장면의 4D reconstruction은 최근 4D Gaussian Splatting 등의 발전으로 고품질 렌더링이 가능해졌지만, 대부분의 기존 방법은 여전히 다수의 동기화된 카메라에 의존한다. 이를 줄이기 위해 monocular/sparse-view reconstruction 연구들은 depth, tracking, SMPL 등의 geometric prior를 활용해 왔지만, sparse input에서는 관측 부족으로 인해 novel view에서 floating artifact, missing detail, geometric distortion 등이 쉽게 발생한다.
한편 최근에는 video diffusion model을 이용해 부족한 view를 생성하는 방향이 등장했지만, scene-level 환경에서는 생성 결과에 spatial inconsistency와 temporal inconsistency가 존재한다. 특히 view 간 appearance 차이, flickering, 불안정한 motion 등이 4D reconstruction에 그대로 반영되면 blur와 artifact를 유발하기 때문에, sparse-camera 환경에서 고품질이면서 시공간적으로 일관된 reconstruction을 얻는 것은 여전히 어려운 문제다.
Method & Technical Details
Preliminary
먼저 논문은 dynamic scene 표현으로 4D Gaussian Splatting을 사용한다. 기존 3DGS가 Gaussian을 3차원 공간에 배치한다면, 4DGS는 여기에 time 축을 하나의 독립적인 차원으로 추가한다:
\[\mu = (\mu_x, \mu_y, \mu_z, \mu_t)\]covariance도
\[\Sigma \in \mathbb{R}^{4 \times 4}\]로 표현된다. 즉, 하나의 primitive가 단순히 공간상의 위치뿐 아니라 어느 시간대에 존재하는지와 시간에 따른 변화까지 함께 표현하는 구조다. Rotation 역시 4D rotation으로 정의되며, 논문에서는 quaternion pari나 4D rotor 같은 기존 표현 방식을 언급한다.
특정 시간 $t$의 장면을 렌더링할 대는 이 4D Gaussian을 그 시점의 3D Gaussian으로 slice한다.
\[G_{3D}(x,t) = e^{-\frac{1}{2}\lambda(t-\mu_t)^2} e^{-\frac{1}{2}[x-\mu(t)]^T\Sigma_{3D}^{-1}[x-\mu(t)]}\]해당 수식에서 시간 $t$가 Gaussian의 temporal center $\mu_t$와 얼마나 가까운지에 따라 해당 Gaussian이 그 시점에서 얼마나 기여할지가 결정된다. 여기서 첫 번째 항은 시간 방향의 영향도, 두 번째 항은 일반적인 3D Gaussian의 공간적 영향도라고 이해하면 된다. 이후 렌더링은 일반 3DGS의 differentiable splatting을 사용한다.
다음으로 K-Planes를 설명한다. K-planes는 고차원 scene representation을 직접 큰 voxel grid로 저장하는 대신, 여러 개의 2D plane으로 factorization해서 표현하는 방식이다.
4D dynamic scene $(x,y,z,t)$의 경우에는 다음 6개 plane을 사용한다:
- 공간 plane: $xy, xz, yz$
- 시공간 plane: $xt, yt, zt$
그래서 흔히 HexPlane이라고 부른다. 특정 좌표 $(x,y,z,t)$가 들어오면 각 plane에서 feature를 sampling하고, 이를 조합해 해당 위치의 feature를 얻는다.
이 representation은 기존 dynamic NeRF와 4DGS에서 많이 사용되어 왔다. NeRF에서는
\[M : (p,t) \rightarrow \Delta p\]처럼 world-space point를 canonical space로 보내는 deformation을 예측하는 데 쓰이고, 4DGS에서는
\[F : (G,t) \rightarrow \Delta G\]처럼 canonical Gaussian $G$가 시간 $t$에서 어떻게 변형되는지를 예측하는 데 사용된다. 최종적으로 변형된 Gaussian은
\[G' = G + \Delta G\]가 되고, 이를 이용해 해당 시점의 이미지를 렌더링한다.
Framework
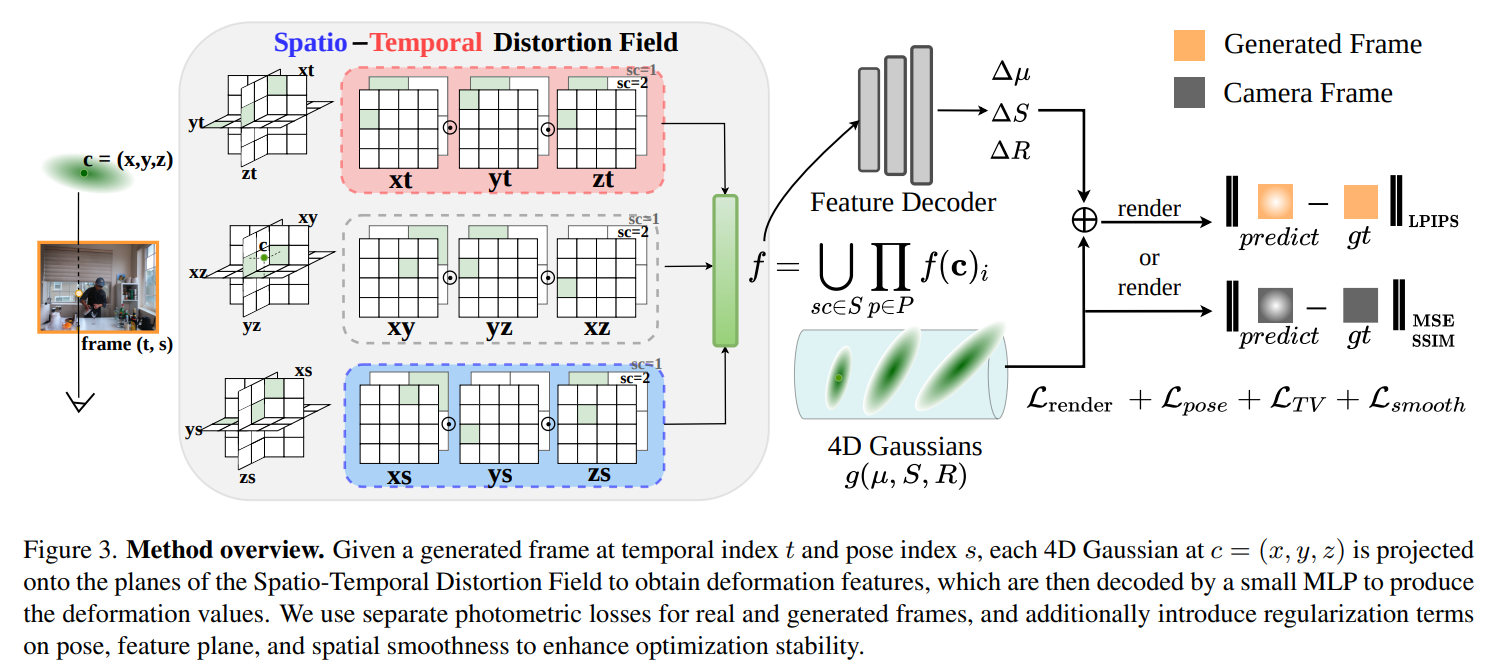
sparse camera로 실제 관측한 영상만으로 4DGS를 학습하기에는 정보가 부족하므로, video diffusion model이 생성한 추가 view까지 함께 사용하되, 생성 영상의 불일치는 별도로 모델링하는 것이 목표다.
먼저 입력으로 $N$개의 sparse camera video가 있고, 각 video는 $L$개의 frame을 가진다. 논문은 실제 camera에서 얻은 영상과 pose를 다음과 같이 input views $V_I$로 정의한다.
\[V_I = \{(I_s^t, [R \vert T]_s) \vert t=0,...,L, \; s=0,...,N\}\]여기서 $t$는 time index이고, $s$는 camera/view index다. 그리고 $I_s^t$는 camera $s$에서 시간 $t$에 촬영한 image고, $[R \vert T]_s$는 해당 camera pose다.
그리고 video diffusion model을 이용해 실제로 존재하지 않았던 새로운 camera trajectory의 video를 생성하고, 이를 generated views $V_G$라고 정의한다.
\[V_G = \{(I_s^t, [R \vert T]_s) \vert t=0,...,L,\; s=0,...,M\}\]즉 최종적으로 4DGS는 단순히 실제 sparse camera만 사용하는 것이 아니라,
\[V_I + V_G\]를 함께 사용해서 학습된다. generated views가 sparse camera 사이의 빈 공간을 채워주는 additional observation 역할을 하는 것이다.
그런데 generated view를 그대로 쓰면 문제가 생긴다. Video diffusion model은 denoising 과정에서 생성 결과가 정확한 3D geometry를 반드시 유지하도록 보장하지 않기 때문에, 생성된 영상에는 space와 time 방향의 geometric inconsistency가 존재한다.
이런 generated image들을 GT처럼 그대로 4DGS에 supervision으로 넣어버리면, 서로 모순되는 image들을 하나의 4D geometry로 맞추려고 하게 된다. 그 결과 4DGS 자체의 geometry가 망가지면서 blur나 artifact가 발생한다.
즉, generated views는 observation을 늘려준다는 장점이 있지만, 동시에 잘못도니 geometry도 포함하고 있다.
그래서 논문에서는 하나의 canonical 4D Gaussian scene $G_{4D}$를 두고, generated view가 가진 오류를 scene 자체에 흡수시키지 않는다.
대신 별도의 Spatio-Temporal Distortion Field F가
\[F : (G_{4D}, t, s) \rightarrow \Delta G_{4D}\]를 예측하도록 한다. 여기서 $t$는 해당 generated frame의 시간, $s$는 해당 generated camera/view의 pose index라고 보면 된다.
Spatio-Temporal Distortion Field
이번에는 해당 수식을 어떻게 구현할지를 설명하고자 한다:
\[F : (G_{4D}, t, s) \rightarrow \Delta G_{4D}\]여기서 가장 중요한 것을 Gaussian의 3D 위치 $(x,y,z)$, 시간 $t$, 생성 view의 pose index $s$를 함께 사용해서, 특정 generated observation에서 나타난 왜곡을 예측하는 것이다.
그럼 이제 앞의 말을 통해서 우리는 5D 입력을 제공한다는 것을 알 수 있을 것이다:
\[c = (x,y,z,t,s)\]각 Gaussian의 좌표를 위의 수식처럼 둔다. 여기서 $x,y,z$는 Gaussian의 공간을 의미하고, $t$는 frame의 시간 index를 의미하며, $s$는 generated camera/view의 pose index를 의미한다.
Spatio-Temporal Distortion Field(STDF)가 알고 싶은 것은
이 Gaussian이 특정 시간 $t$, 특정 camera pose $s$에서 생성 영상 안에서 얼마나 왜곡 되었는가?”
이다.
5차원 $(x,y,z,t,s)$ 전체를 dense한 5D grid로 저장하면 너무 비싸기 때문에, 앞의 K-planes처럼 2D planes들로 factorization한다.
5개 dimension 중 2개를 고르는 모든 조합은 원래 10개 이다:
\[xy, xz, yz, xt, yt, zt, xs, ys, zs, ts\]가 된다. 그런데 논문의 경우에는 $ts$ plane을 제외한다. 저자들은 $(t,s)$ 조합 자체에는 공간적인 위치 정보가 없기 때문에 Gaussian의 distortion을 표현하는 데 사용하지 않는다고 설명한다.
그래서 최종적으로 9개의 plane을 사용한다:
\[P = {P_{xy},P_{xz},P_{yz},P_{xt},P_{yt},P_{zt},P_{xs},P_{ys},P_{zs}}\]9개라서 이를 Ennea-plane이라고 부른다.
이제 각 plane에서 featrue를 sampling 해보자. 특정 Gaussian에 대해
\[c = (x,y,z,t,s)\]가 주어졌다고 해보자. 이 좌표를 각 2D plane에 projection한다. 예를 들어,
\[(x,y,z,t,s)\]를 $xt$ plane에 투영하면
\[(x,t)\]만 사용하고, $xs$ plane에서는
\[(x,s)\]를 사용한다. 그 위치의 feature는 bilinear interpolation으로 얻는다:
\[f(c)_c = interp(P_c, \pi_c(c))\] \[c \in \{ xy, xz, yz, xt, yt, zt, xs, ys, zs \}\]여기서 $P_c$는 해당 fature plane 이고, $\pi_c(c)$는 5D coordinate를 해당 2D plane으로 projection을 의미하며, interp는 bilinear interpolation을 의미한다.
예를 들어 $P_{xt}$라면
\[f(x)_{xt} = interp(P_{xt}, (x,t))\]가 된다. 그리고 우리는 9개의 feature를 어떻게 합쳐야 할 지도 생각을 해야한다. 만약 우리가 하나의 Gaussian에서 9개의 plane feature를 얻었다고 하자.
논문은 이 feature들을 element-wise multiplication해서 하나의 feature vector로 결합한다.
\[f(c) = \prod_{P_c \in P} f(c)_c\]형태라고 보면 된다. 그리고 이 feature plane들은 multi-resolution으로 구성되어 있기 때문에, 각 resolution에서 multiplication으로 얻은 feature들을 마지막에 concatenate한다.
그러면 왜 multiplication을 할까?
K-planes 계열에서 많이 사용하는 방식인데, 각 plane이 표현하는 조건을 동시에 만족하는 위치의 feature를 만들기 위해서다. 예를 들어
- $P_{xy}$: 이 Gaussian이 공간적으로 어디 있는가
- $P_{xt}$: 그 위치가 시간에 따라 어떻게 변하는가
- $P_{xs}$: view가 바뀔 때 어떻게 달라지는가
를 각각 가지고 있고, 이들을 결합해서 표현하는 것이다.
이렇게 얻은 최종 feature $f(c)$를 lightweight multi-head MLP에 넣는다. MLP는 하나의 공통 feature를 바탕으로 Gaussian의 여러 attribute에 대한 distortion을 각각 예측한다.
논문에서 예측하는 것은 크게
\[\Delta \mu\]position,
\[\Delta q_l, \Delta q_r\]rotation,
\[\Delta s\]scaling 이다.
그래서 원래 canonical Gaussian의 attribute가
\[(\mu, q_l, q_r, s)\]라면 distorted Gaussian은
\[(\mu^' , q_l^' , q_r^' , s^') = (\mu + \Delta \mu, q_l + \Delta q_l, q_r + \Delta q_r, s + \Delta s)\]로 만든다. 즉 STDF는 새로운 Gaussian을 만드는 것이 아닌, canonical Gaussian을 generated observation에 맞게 잠시 변형시키는 offset을 예측하는 것이다.
그리고 여기서 가장 중요한 부분은 Real view와 Generated view를 다르게 처리한다는 부분이다.
실제 촬영된 image를 fitting할 때는
\[G_{4D}\]original canonical Gaussian을 그대로 사용한다.
Diffusion이 만든 image를 fitting할 때만
\[G^'_{4D} = G_{4D} + \Delta G_{4D}\]를 사용한다. 즉 generated frame의 이상한 geometry를 맞추기 위해 canonical scene 자체를 망가뜨리는 대신, STDF가 그 차이를 대신 흡수하는 것이다.
예를 들어 diffusion이 어떤 frame에서 사람 손을 실제 위치보다 약ㄱ나 오른쪽에 만들었다고 해보자.
그때 canonical Gaussian의 손 자체를 오른쪽으로 이동시키는 것이 아니라,
\[\Delta \mu = (+ \delta x, 0, 0, ...)\]같은 distortion을 generated view에만 적용한다.
그래서 학습 관점에서는
\[\text{Generated image} \appros Render(G_{4D}+ \Delta G_{4D})\]로 설명하고,
실제 scene은
\[G_{4D}\]에 계속 남겨두는 것이다.
inference 때는 $\Delta G_{4D}$와 STDF는 제거하고, $G_{4D}$ canonical 4D Gaussian만 사용한다. STDF의 목적은 generated video의 distortion을 최종 4D Scene에 넣는 것이 아닌 학습 중 generated observation에 존재하는 오류를 따로 설명해 줌으로써 canonical 4DGS가 그 오류를 배우지 않도록 하는 것이다.
Optimization
이 논문에서는 generated video까지 reconstruction에