[Paper Review, KR] Streaming Autoregressive Video Generation via Diagonal Distillation
Paper Information
Title: Streaming Autoregressive Video Generation via Diagonal Distillation
Authors: Jinxiu Liu, Xuanming Liu, Kangfu Mei, Yandong Wen, Ming-Hsuan Yang, Weiyang Liu
Venue: ICLR 2026
Link: [Paper], [Project], [GitHub]
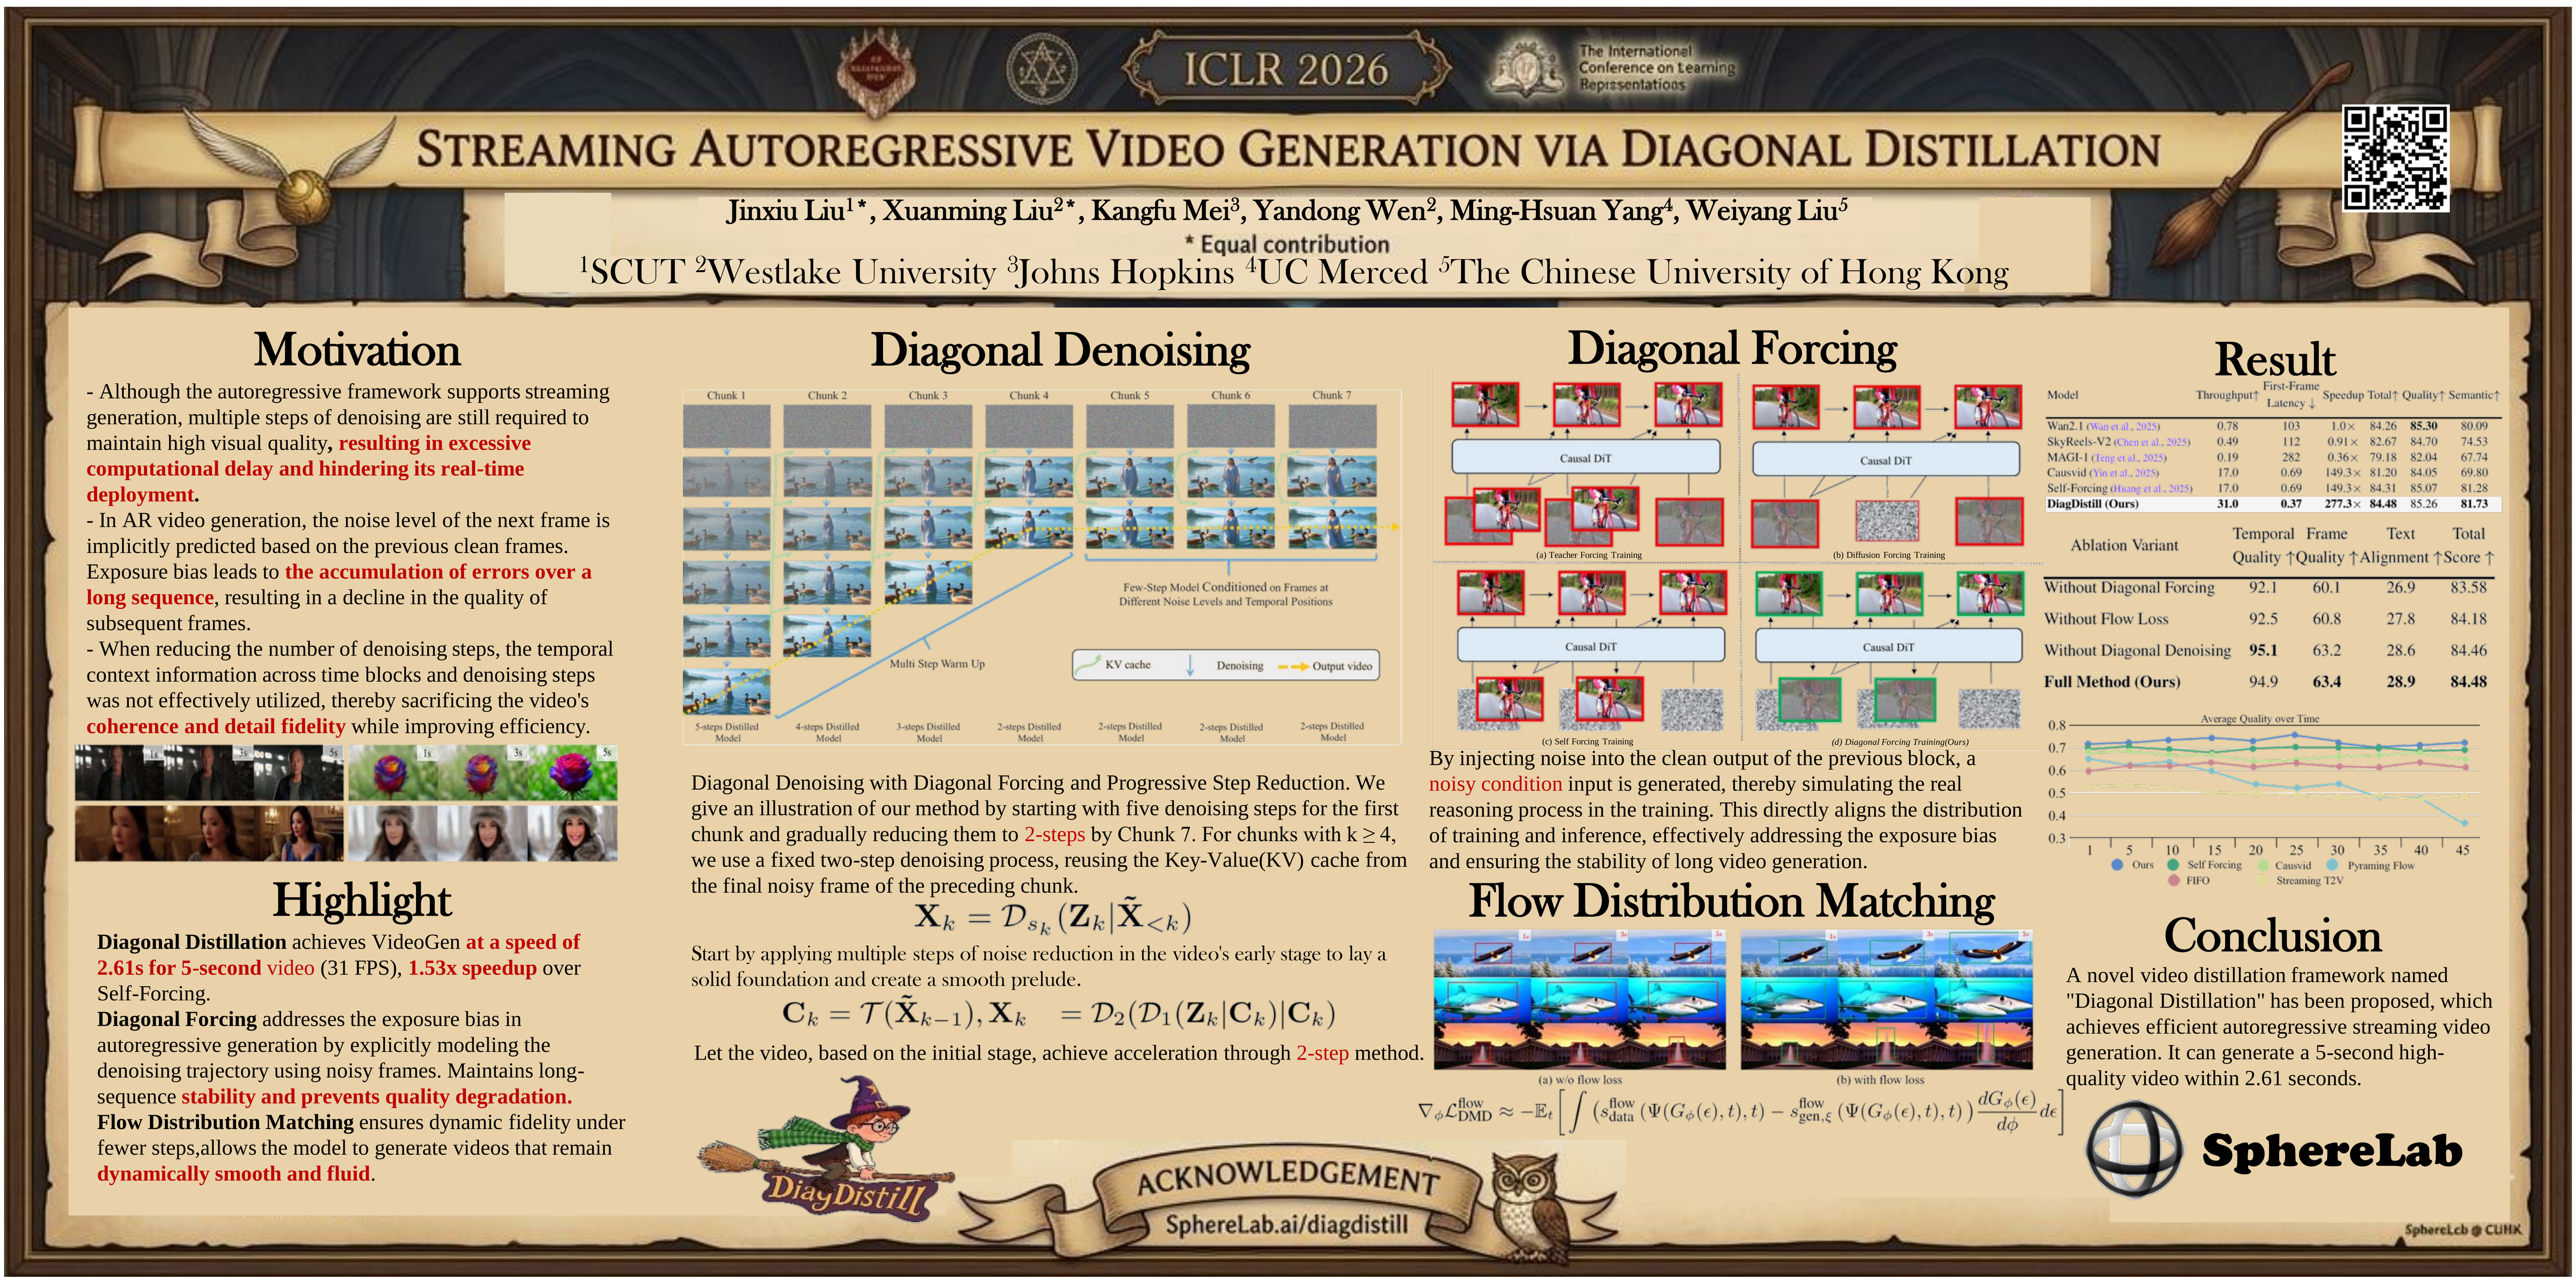
Teaser Image (Poster)
Introduction
최근 video generation은 diffusion model의 발전으로 높은 시각적 품질을 달성했지만, 대부분의 video diffusion model은 모든 frame이 서로를 참조하는 bidirectional attention 구조를 사용하기 때문에 전체 영상을 한 번에 생성해야 한다. 이런 방식은 offline generation에는 효과적이지만, 현재 frame을 생성할 때 미래 frame을 사용할 수 없는 streaming·real-time 환경에는 적합하지 않다. 이를 보완하기 위해 autoregressive video generation이 등장했으며, video를 frame 또는 chunk 단위로 순차적으로 생성함으로써 streaming에 더 적합한 구조를 제공한다. 이후에는 autoregressive modeling과 diffusion을 결합한 hybrid 방식들이 제안되어 기존 GPT-style AR model보다 높은 visual quality를 달성했지만, 각 chunk를 생성할 때 여러 번의 denoising이 필요해 inference latency가 여전히 큰 문제가 남아 있었다.
이러한 계산량을 줄이기 위해 diffusion distillation 연구가 활발히 진행되었으며, progressive distillation이나 consistency 계열의 deterministic 방식과 DMD, DMD2, ADD 등의 distributional/hybrid 방식이 대표적이다. 하지만 이들 방법은 주로 image generation을 중심으로 개발되어, video에 직접 적용하면 temporal dependency와 inter-frame consistency를 충분히 반영하지 못하는 한계가 있다. 특히 denoising step을 크게 줄일수록 motion이 약해지거나 temporal coherence가 떨어지고, autoregressive generation에서는 이전에 생성된 결과를 계속 condition으로 사용하기 때문에 prediction error가 장시간 누적될 수 있다. CausVid와 Self-Forcing 같은 최근 연구들이 latency와 train–inference mismatch를 줄이려 했지만, 여전히 여러 denoising step이 필요하며 long video에서는 quality degradation이나 oversaturation 같은 문제가 남아 있다.
Method & Technical Details
Preliminary
다른 논문들과 같이 해당 논문은 diffusion을 설명하는 것부터 시작한다. 원본 데이터 $x \sim p_{real}$ 에 timestep $t$에 따라 noise를 넣으면 이렇게 된다:
\[q_t(x_t | x) \sim \mathcal{N}(\alpha_t x, \sigma_t^2 I)\]모델이 noisy sample $x_t$를 입력받아서 원래 clean sample에 가까운
\[\mu_{real}(x_t, t)\]를 예측하도록 학습된다. 그리고 score function 식은
\[s_{real}(x_t, t) = \nabla_{x_t} log p_{real, t}(x_t) = - \frac{x_t - \alpha_t \mu_{real}(x_t,t)}{\sigma_t^2}\]이렇게 생겼으며, 지난 많은 논문에 말했듯이 직관적으로 “현재 noisy sample을 어느 방향으로 움직여야 real data distribution 쪽으로 갈 수 있는지”를 알려주는 것이 score라고 하는 gradient다.
그런데 일반 diffusion의 경우에는 여러 denoising step이 필요하기 때문에 느리다는 단점이 있다. 이를 위해 DMD, Distribution Matching Distillation이 등장한다. DMD의 목표는 여러 step을 사용하는 teacher diffusion model의 distribution을 few-step student generator가 따라가게 만드는 것이다. 즉, 적은 step 만으로도 teacher model의 결과물과 대등하게 나오도록 하는 것이 목표다.
논문에서는 student를
\[G_{\theta}(z), \; z \sim \mathcal{N}(0, I)\]라고 표현한다.
DMD는 student가 생성한 distribution $p_{fake}$를 real/teacher distribution $p_{real}$과 비슷하게 만드는 것이다. 즉, 이 둘의 차이를 줄이는 것인데, 논문에는 KL divergence를 이용해서
\[KL(p_{fake,t} || p_{real,t})\]를 최소화한다고 표현한다. 핵심은 다음의 student $G_{\theta}$를 업데이트할 때 사용되는 식이다.
\[s_{real} - s_{fake}\]이는 teacher/real distribution의 score와 student가 만든 distribution의 score가 얼마나 다른가?를 나타내는 식이다. 이를 통해 student를 업데이트한다. DMD에 관련한 자세한 내용은 FlashWorld (ICLR 2026 Oral) 논문 리뷰 페이지의 Preliminary 섹션에서 확인할 수 있으니 궁금하면 확인하길 바란다.
이제 여기서 저자들은 문제 제기를 한다. DMD는 원래 image generation 중심으로 만들어진 방식이기 때문에,
\[L_{reg} = E_{z,y}d(G_{\theta}(z), y)\]같은 loss는 주로 각 frame 자체의 품질을 맞추는 데 집중한다. 즉, frame 1, frame 2, frame 3 … 각각의 경우는 teacher와 비슷하게 만들 수는 있지만, Frame 1 $\rightarrow$ Frame 2 $\rightarrow$ … 과 같이 사이의 motion이나 temporal consistency가 자연스럽게 이어진다는 보장이 없다.
논문에서는 이를 “기존 DMD의 regression loss가 per-frame quality는 보장하지만 temporal coherence와 long-range dependency를 명시적으로 모델링하지 못한다”라고 표현한다.
Diagonal Denoising & Diagonal Forcing
이 섹션에서는 두 가지 핵심 기술에 대해 설명한다.
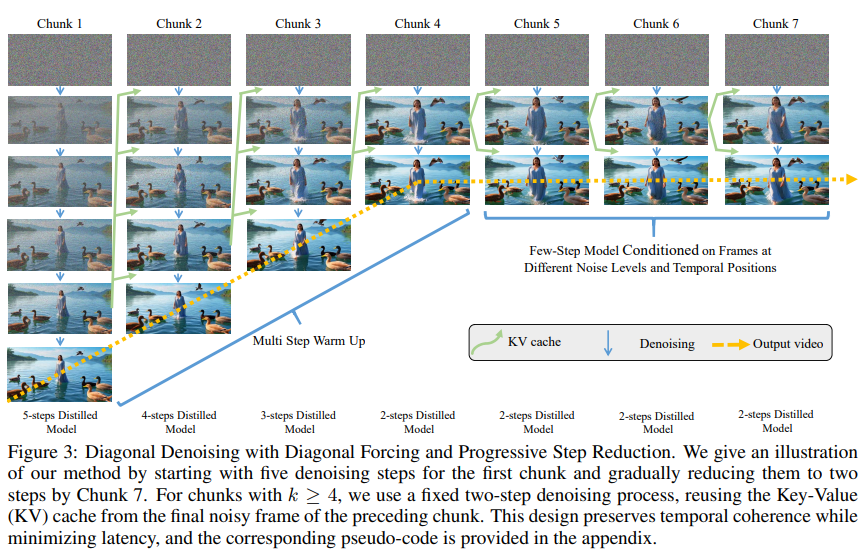
- Diagonal Denoising: 앞쪽 chunk는 많이 denoise하고 뒤쪽 chunk는 적게 denoise 해서 속도를 높이는 방법.
- Diagonal Forcing: 뒤쪽 chunk가 적은 step으로도 안정적으로 생성될 수 있도록, 이전 chunk의 적당히 noisy한 상태를 KV cache/context로 전달하는 방법.
기존 autoregressive video diffusion이라면 모든 chunk에 같은 수의 denoising step을 사용하는 것이 자연스럽다. 그런데 저자들은 앞쪽 chunk가 이후 chunk를 위한 structural prior 역할을 한다고 본다.
즉, 만약 앞쪽 chunk에서 이미 인물의 모습, 배경, 구조 등등이 정해지면, 뒤쪽 chunk는 이를 context로 받아 생성되므로 처음부터 그만큼 많은 계산을 할 필요가 없다는 주장이다. 그래서 저자들은 chunk가 진행될 때마다 denoising step이 줄어드는 progressive reduction을 설명한다:
\[X_k = D_{s_k} (Z_k | \tilde{X}_{<k}), s_k = 5,4,3\]여기서 $Z_k \sim \mathcal{N} (0,I)$이므로 각 새로운 chunk 자체는 여전히 Gaussian noise에서 시작한다. $D_{s_k}$는 $s_k$번 denoising하는 distilled model이고, $\tilde{X}_{<k}$는 이전 chunk들에서 전달된 noisy context다. 즉 뒤의 chunk가 덜 noisy하게 시작하는 것이 아니라, 좋은 temporal context가 있기 때문에 적은 step으로도 noise를 제거할 수 있다는 아이디어다.
Chunk 4 이후에는 2-step으로 고정한다.
\[C_k = T(\tilde{X}_{k-1})\] \[X_k = D_2(D_1(Z_k | C_k)| C_k)\]즉 이전 chunk 정보를 이용해 $T$ 인 conditioning module을 이용해서 conditioning $C_k$를 만들고, 두 번만 denoising $D_1, D_2$ 한다.
그런데, 단순히 “5 $\rightarrow$ 4 $\rightarrow$ 3 $\rightarrow$ 2” 방식으로 step 수만 줄이면 문제가 있다. Chunk $k$를 만들 때 이전 Chunk $k-1$의 완전히 clean한 결과만 condition으로 준다고 한다면,
\[\text{Chunk} \; k-1 \rightarrow \text{clean output} \rightarrow \text{KV cache} \rightarrow \text{Chunk k}\]그런데 Chunk $k$는 현재 diffusion/flow denoising의 특정 noise level에 있다. 그러면 모델은 clean context를 보면서 동시에 다음 chunk는 지금 어느 noise level에 있어야 하는지까지 암묵적으로 판단해야 한다.
논문이 이에 대해 implicit next-noise-level prediction 문제라고 표현하고, 이 prediction에 작은 오차가 생기면 autoregressive하게 누적될 수 있다고 말한다. 그래서 저자들은 clean previous chunk를 그대로 사용하는 것이 아니라 일부러 적당한 noise를 다시 넣어서 사용한다(정확히는 전 Chunk에서 denoising 중에 나오는 intermediate latent에 noise를 조금 넣고 이를 KV cache에 저장하는 방식으로 진행한다):
\[\tilde{X}_{k-1} = \sqrt{\alpha_{k-1}} X_{k-1} + \sqrt{1-\alpha_{k-1}} \epsilon, \; \epsilon \sim \mathcal{N}(0, I)\]$X_{k-1}$은 이전 chunk의 clean output이고, $\tilde{X}_{k-1}$은 거기에 controlled noise를 추가한 상태다. 그러면 흐름은 이렇게 바뀐다.
\[\text{Chunk} \; X_{k-1} \rightarrow \text{noise 추가} \rightarrow \text{partially noisy} \; \tilde{X}_{k-1} \rightarrow \text{KV cache} \rightarrow \text{Chunk k}\]그런데 의문이 들 수 있다. 왜 noisy context가 이를 해결할 수 있는지에 대해서다. 핵심은 현재 chunk와 이전 context의 denoising 상태를 더 잘 맞춰주는 것이다.
Clean context를 그대로 주게 된다면, Previous context(Clean)와 Current chunk(Noisy) 간의 noise-level mismatch가 크다. 반면 Diagonal Forcing에서는 Previous Context에 noise를 추가함으로써 Current chunk 간의 noise-level이 비슷해진다.
그래서 여기까지 본다면, Diagonal Denoising은 step 수를 progressive하게 reduction해서 계산량을 줄이는 쪽이라면, Diagonal Forcing은 이렇게 step을 줄여도 품질이 무너지지 않도록 연결해서 temporal coherence와 long-term stability를 유지하는 역할을 수행한다.
Flow Distribution Matching
여기서 앞의 Diagonal Denoising 때문에 발생하는 하나의 문제를 또 발견한다. 이는 few-step으로 줄였을 때 motion이 약해지는 문제다. 논문에서는 이를 motion attenuation이라고 표현하고, teacher가 충분한 denoising step을 거치면 물체가 프레임 사이에서 크게, 자연스럽게 이동하는데, student를 2-step 정도로 강하게 줄이면 spatial appearance는 그럴듯해도 움직임의 크기가 작아진다는 것이다.
저자들은 이 원인을 denoising trajectory가 너무 짧아지면서 temporal dynamics를 충분히 복원하지 못하는 것으로 설명한다. 그래서 단순히 DMD로는 부족하고, motion distribution 자체도 teacher와 맞춰야 한다고 말한다:
\[E_{motion} = D_{KL} (p_{teacher}(F(x) | x_t) || p_{student}(F(x) | x_t))\]여기서 $F(x)$는 video에서 추출한 motion flow feature다. 핵심은 “teacher와 student가 비슷한 frame을 만드는지만 보는 것이 아닌, 두 모델이 만들어내는 motion feature의 분포도 비슷하게 만든다”라는 것이다.
DMD는 기존에
\[p_{student}(x) \approx p_{teacher}(x)\]를 맞추는 방향이라면, 여기에 추가로
\[p_{student}(F(x)) \approx p_{teacher}(F(x))\]를 맞춘다고 생각하면 된다. 추가적으로 Flow Distribution Matching도 DMD 방식으로 학습한다.
\[\nabla_{\phi} L_{DMD}^{flow} = \nabla_{\phi} KL(p_{gen,flow,t} || p_{data,flow,t})\]즉, spatial domain에서 했던 distribution matching을 motion feature domain으로 확장한다. 그래서
\[s_{data}^{flow} - s_{gen}^{flow}\]의 차이를 이용해 student를 업데이트한다.
기존의 DMD의 경우에는 student image distribution과 teacher image distribution을 matching하는 방법이었다면, Flow DMD의 경우에는 student motion distribution과 teacher motion distribution을 matching하는 방법이라고 보면 된다.
그런데, 여기서 중요한 게 있다. 여기서 말하는 FLOW는 RAFT 같은 optical flow를 말하는 것이 아니다. 대신 video diffusion의 latent space에서 직접 motion feature를 뽑아 사용한다. 정확히는,
\[(\text{Latent frame t} - \text{Latent frame t+1}) \rightarrow (X_{t+1} - X_t) \rightarrow \text{Convolution layers} \rightarrow \text{MLP} \rightarrow \text{Motion feature} \; F(x)\]즉, consecutive latent의 차이를 먼저 계산하고, 여기에 convolution을 적용해 local motion pattern을 추출한 뒤 MLP로 feature adaptation을 한다. 그래서 여기서의 FLOW는 latent difference 기반의 learnable motion representation에 가깝다.
Flow DMD의 목표는
\[\nabla_{\phi}L_{DMD}^{flow} = \mathbb{E}[\nabla_{\phi}D_{KL}(p_{gen,flow,t} || p_{data,flow,t})]\]로 student가 만드는 motion-feature distribution을 real/teacher 쪽 motion-feature distribution에 가깝게 하겠다는 것이다. 그러면 flow score는
\[s^{flow} (x_t, t) = \nabla_{x_t} log p(F(x) | x_t)\]로 정의한다. 이는 일반 diffusion과 다르게 현재 noisy video latent $x_t$를 어느 방향으로 변화시키면 원하는 motion feature $F(x)$가 더 그럴듯해지는지를 나타내는 gradient라고 보면 된다.
\[\nabla_{\phi} L_{\mathrm{DMD}}^{\mathrm{flow}} \approx -\mathbb{E}_{t} \left[ \int \left( s_{\mathrm{data}}^{\mathrm{flow}} \left( \Psi(G_{\phi}(\epsilon), t), t \right) - s_{\mathrm{gen},\phi}^{\mathrm{flow}} \left( \Psi(G_{\phi}(\epsilon), t), t \right) \right) \frac{dG_{\phi}(\epsilon)}{d\phi} \, d\epsilon \right].\]이를 통해 결국 $s_{data}^{flow} - s_{gen}^{flow}$, 즉 real/teacher motion distribution이 원하는 방향과 student motion distribution이 원하는 방향의 차이를 계산해서 Generator를 학습한다.
여기서 $\Psi(x,t)$는 video sample $x$를 timestep $t$의 noisy state $s_t$로 만드는 forward noising 연산이다(아마도 기존 DMD 식에서는 forwarding noising 연산을 $F$로 표현하는데, 여기서는 flow extractor를 $F$로 표현해서 $\Psi$를 사용하는 것 같다). 그리고 이에 맞는 regression loss도 기존 전체 loss에 추가한다.
\[L_{reg}^{flow} = \mathbb{E} [\lVert F(G_{\phi}^{teacher}) - F(G_{\phi}^{student}) \rVert _2^2]\]즉 같은 조건에서 teacher와 student가 생성한 video를 각각 teacher/student flow extractor $F(\cdot)$에 넣고, 맞추는 방법이다. 그러면 최종 loss 식이
\[L_{\mathrm{Total}} = \lambda_{\mathrm{spatial}} L_{\mathrm{DMD}}^{(\mathrm{grad})} + L_{\mathrm{reg}} + \gamma \left( \lambda_{\mathrm{flow}} L_{\mathrm{DMD}}^{\mathrm{flow},(\mathrm{grad})} + L_{\mathrm{reg}}^{\mathrm{flow}} \right).\]이렇게 된다.
Experiments
Implementation Details
Wan2.1-T2V-1.3B를 기반 모델로 사용하며, ODE initialization과 Diagonal Distillation 학습에는 VidProM에서 필터링하고 LLM으로 확장한 text prompt를 사용한다. Inference는 단일 NVIDIA H100 GPU에서 수행하고, Tiny VAE와 chunk size 3 frames의 rolling KV cache를 사용한다. KV cache는 최근 4개 chunk의 context를 유지해 memory footprint를 약 17.5 GB로 고정하며, streaming 성능 평가는 throughput(FPS)과 first-frame latency를 함께 측정한다. 평가는 VBench를 사용하며, Temporal Quality는 subject/background consistency, temporal flickering, motion smoothness, dynamic degree의 평균으로, Frame Quality는 aesthetic/imaging quality의 평균으로, Text Alignment는 object, action, color, spatial relation, scene, appearance, style 등 여러 semantic 항목의 평균으로 계산한다.
Comparison with state-of-the-art methods
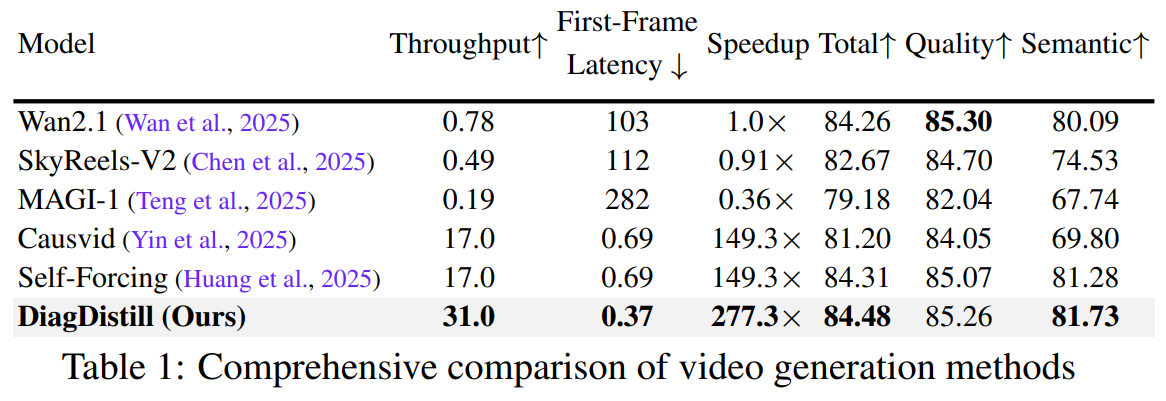
DiagDistill을 Wan2.1, SkyReels-V2, MAGI-1, CausVid, Self-Forcing과 비교한다. DiagDistill은 단일 H100에서 31 FPS, 0.37초 first-frame latency를 기록하며 Wan2.1 대비 277.3× speedup을 달성했고, 기존의 빠른 AR 방식인 CausVid와 Self-Forcing보다도 높은 throughput과 더 낮은 latency를 보였다. 동시에 VBench 기반 평가에서 Total 84.48, Quality 85.26, Semantic 81.73을 기록해 원본 Wan2.1과 유사한 visual quality를 유지하면서도 semantic consistency에서는 경쟁력 있는 성능을 보였으며, qualitative result에서도 복잡한 motion과 texture에서 baseline보다 더 부드러운 transition과 적은 distortion을 보여 속도와 생성 품질 간 trade-off를 효과적으로 개선했음을 확인한다.
Ablation Studies
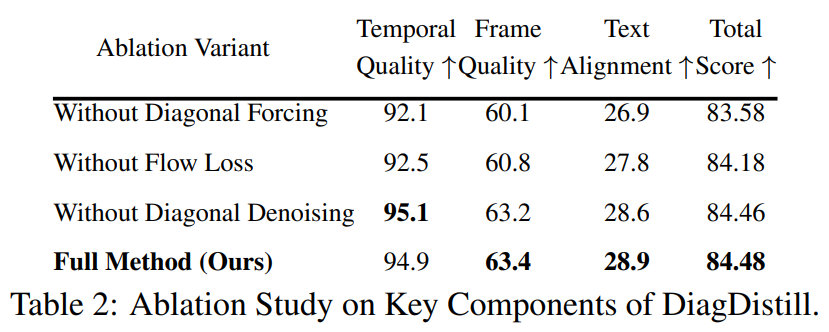
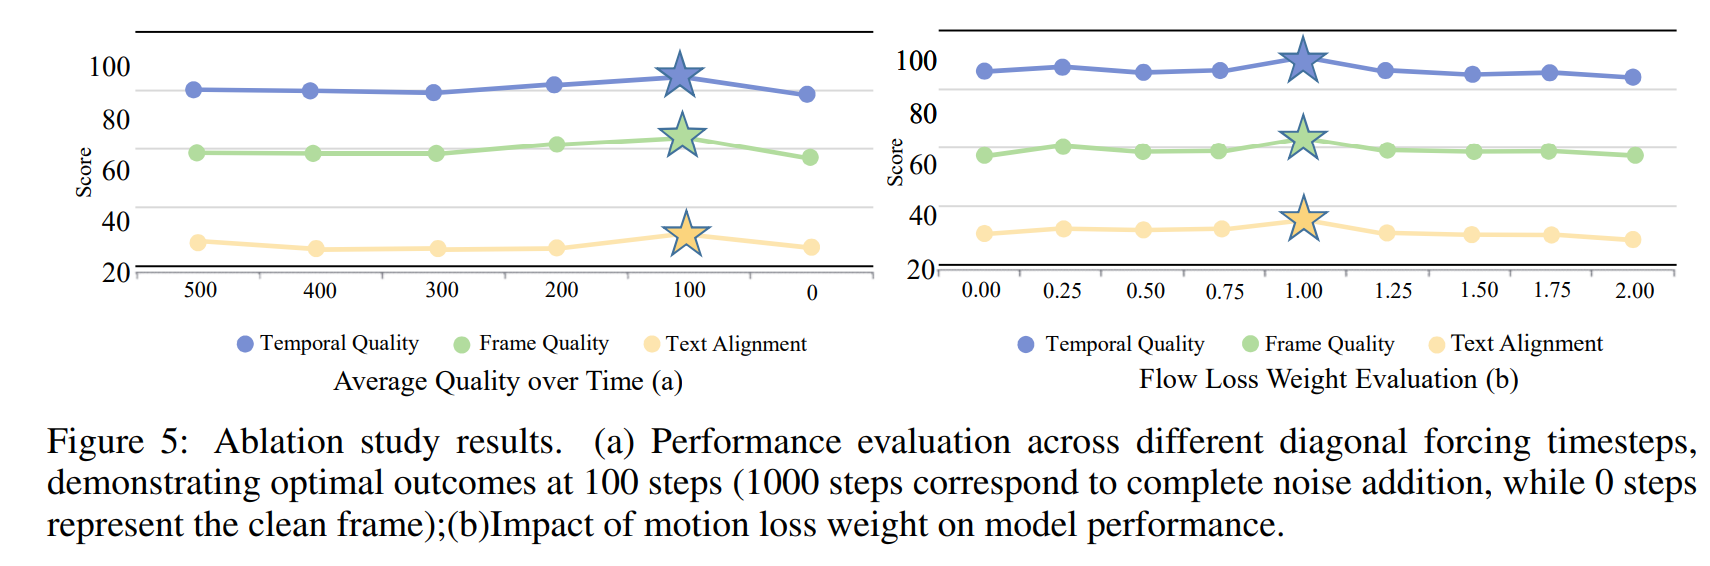
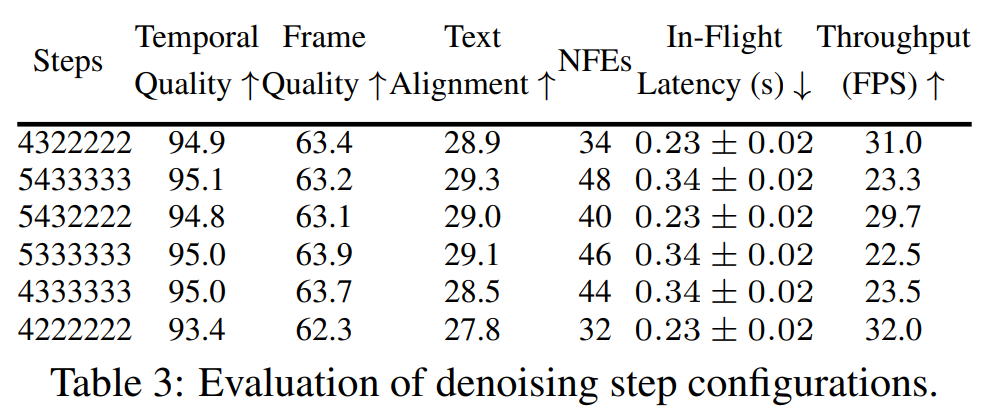
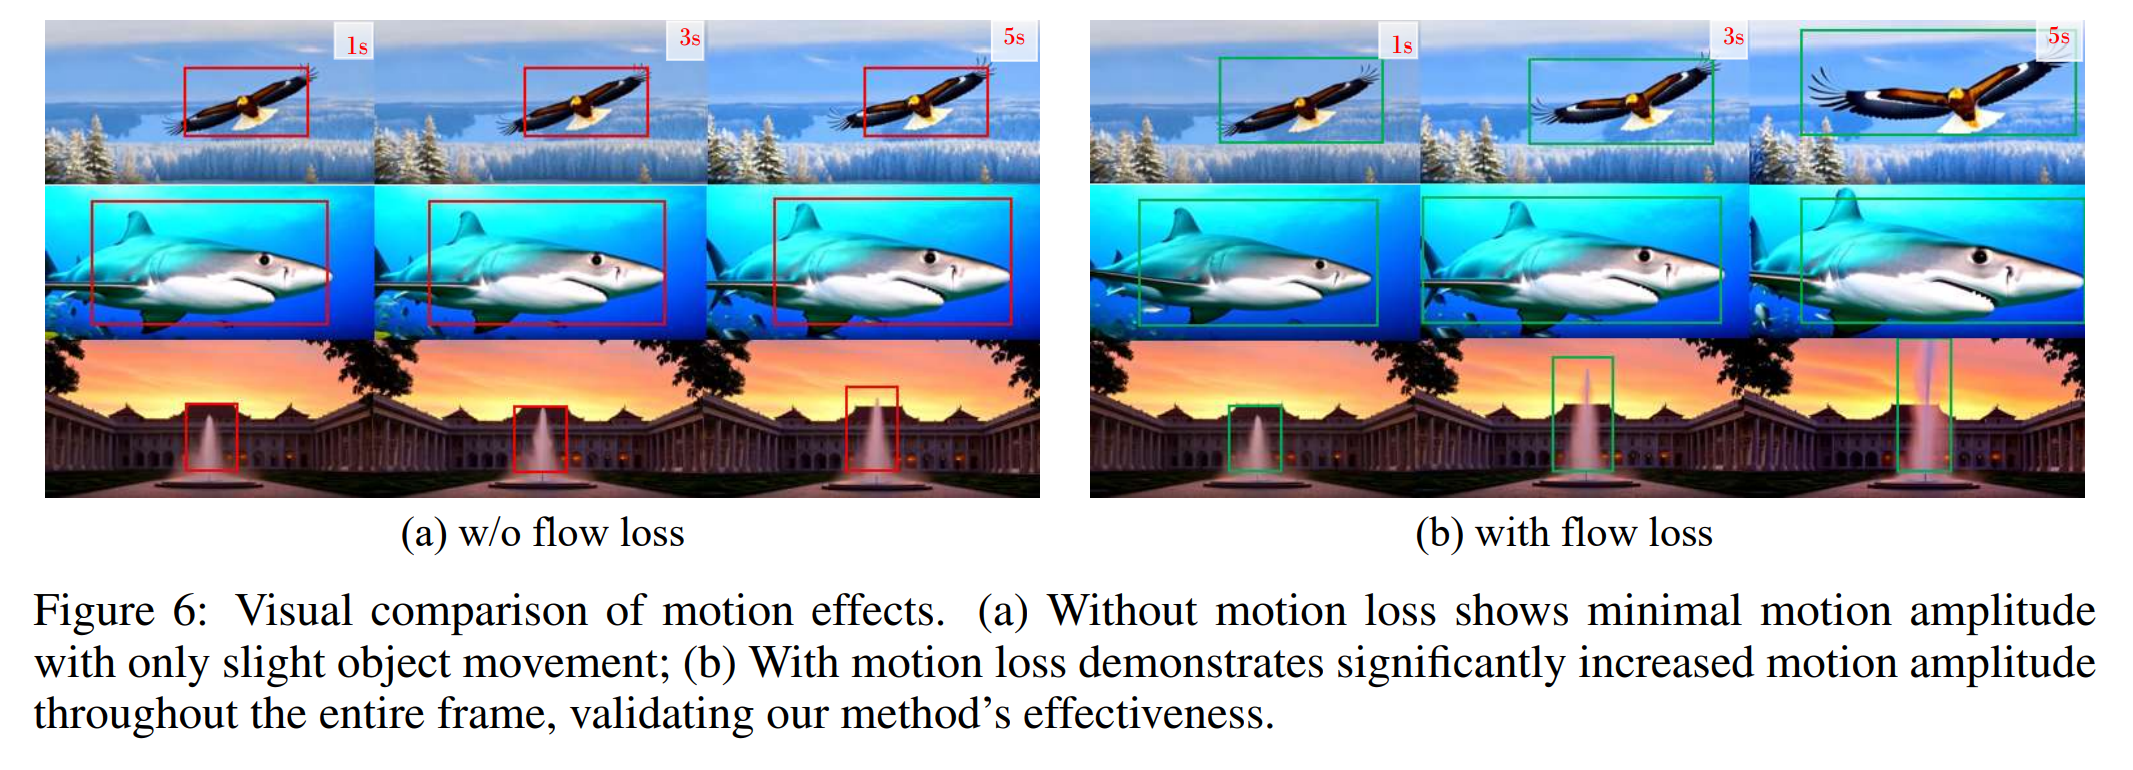
DiagDistill의 핵심 구성요소와 하이퍼파라미터를 각각 제거하거나 변경해 효과를 검증한다. Table 2에서 Diagonal Forcing을 제거하면 전체 성능이 가장 크게 감소하고, Flow Distribution Matching을 제거해도 temporal/frame/text alignment가 모두 하락하는 반면, Diagonal Denoising을 제거하면 품질은 거의 유지되지만 inference cost가 증가해 속도 이점이 사라지는 것을 보여준다. 또한 Figure 5(a)에서는 Diagonal Forcing에 사용하는 noise timestep을 비교해 100 timestep 부근이 가장 좋은 성능을 보였으며, noise가 너무 많으면 structural prior가 약해지고 너무 적으면 over-denoising과 oversaturation 문제가 발생한다고 분석한다. Figure 5(b)에서는 flow loss weight가 1.0일 때 temporal quality, frame quality, text alignment 간의 균형이 가장 좋음을 보이고, Table 3에서는 다양한 denoising schedule을 비교해 5333333이 가장 높은 품질을, 4222222가 가장 높은 throughput을 보였으며, 최종적으로 품질과 속도의 균형이 좋은 4322222를 선택한다. 추가로 Figure 6은 flow loss가 없을 때 motion amplitude가 크게 줄어들고, 이를 적용했을 때 움직임이 보다 뚜렷하게 유지되는 것을 시각적으로 보여준다.
Long Video Generation Evaluation
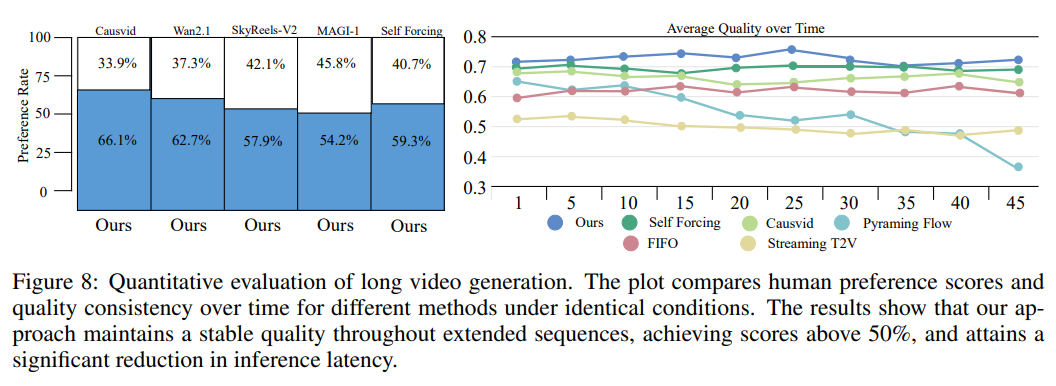
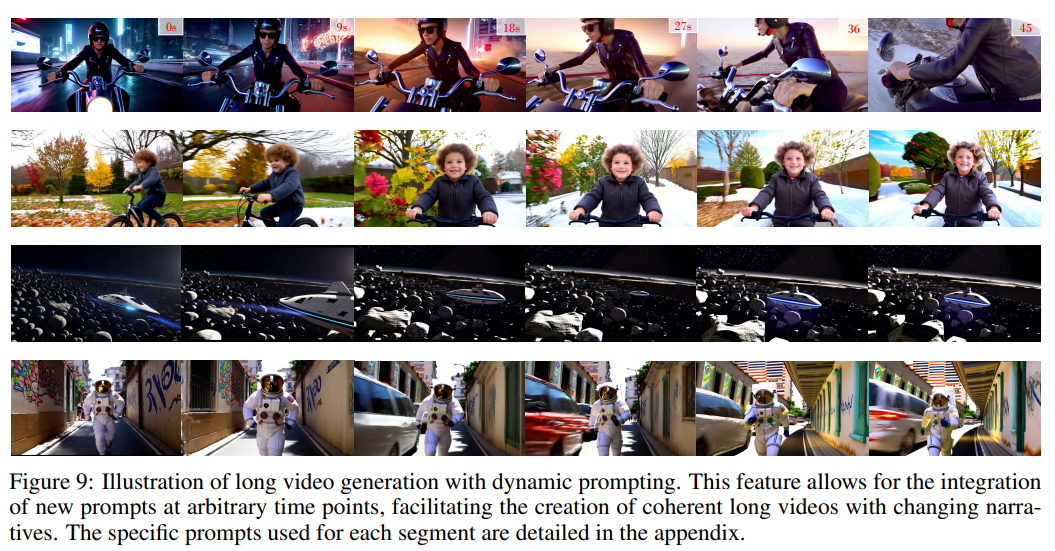
DiagDistill의 장시간 video generation 성능을 평가한다. Figure 8에서 baseline들은 시간이 지날수록 error accumulation으로 perceptual quality가 빠르게 감소하는 반면, DiagDistill은 긴 sequence에서도 비교적 안정적인 quality를 유지한다. 또한 MovieGenBench의 첫 50개 prompt를 대상으로 93명의 참가자가 수행한 user study에서도 overall visual quality, text faithfulness, long-term consistency 측면에서 baseline보다 높은 선호도를 보였으며, 이는 Figure 7의 qualitative comparison에서 CausVid와 Self-Forcing이 장시간 생성 시 saturation distortion과 quality degradation을 보이는 것과도 일치한다. 추가적으로 Figure 9에서는 generation 도중 임의의 시점에 새로운 prompt를 입력할 수 있는 dynamic prompting을 보여주며, 이를 통해 장면이나 action이 변화하는 긴 narrative video도 연속적으로 생성할 수 있음을 보인다.
Contributions
- 모든 video chunk에 동일한 denoising step을 사용하는 대신, 초기 chunk에는 더 많은 step을, 이후 chunk에는 점점 적은 step을 할당하여 temporal context를 활용하면서 계산량을 줄인다.
- 이전 chunk의 denoising trajectory와 partially noised representation을 다음 chunk의 contextual prior/KV cache로 전달하여, training과 inference 간의 mismatch를 줄이고 long-video generation에서의 error accumulation을 완화한다.
- few-step denoising에서 발생하는 motion degradation 및 motion amplitude 감소를 보완하기 위해, teacher와 student의 motion distribution을 맞추는 temporal distillation objective를 추가한다.
Limitations & Future works
- 실제로 깃허브 페이지에 들어가서 결과물 비디오들을 보면 차량이 앞으로 가는 Scene에서 갑자기 후진하는 Scene으로 변하는 결과물이 등장하는데 이는 물리적, 그리고 time 흐름에 맞는 결과물을 항상 보장하는 건 아닌 것 같다.
- 실제 real-time 성능은 H100과 Tiny VAE, rolling KV cache 등의 최적화에 기반하므로, 모든 hardware나 base model에서 동일한 31 FPS가 보장된다는 의미는 아니다.