[Paper Review, KR] Lyra 2.0: Explorable Generative 3D Worlds
Paper Information
Title: Lyra 2.0: Explorable Generative 3D Worlds
Authors: Sherwin Bahmani, Tianchang Shen, Jiawei Ren, Jiahui Huang, Yifeng Jiang, Haithem Turki, Andrea Tagliasacchi, David B. Lindell, Zan Gojcic, Sanja Fidler, Huan Ling, Jun Gao, Xuanchi Ren
Venue: SIGGRAPH Asia 2026
Link: [Paper], [Project], [Github]
Teaser Image
Introduction
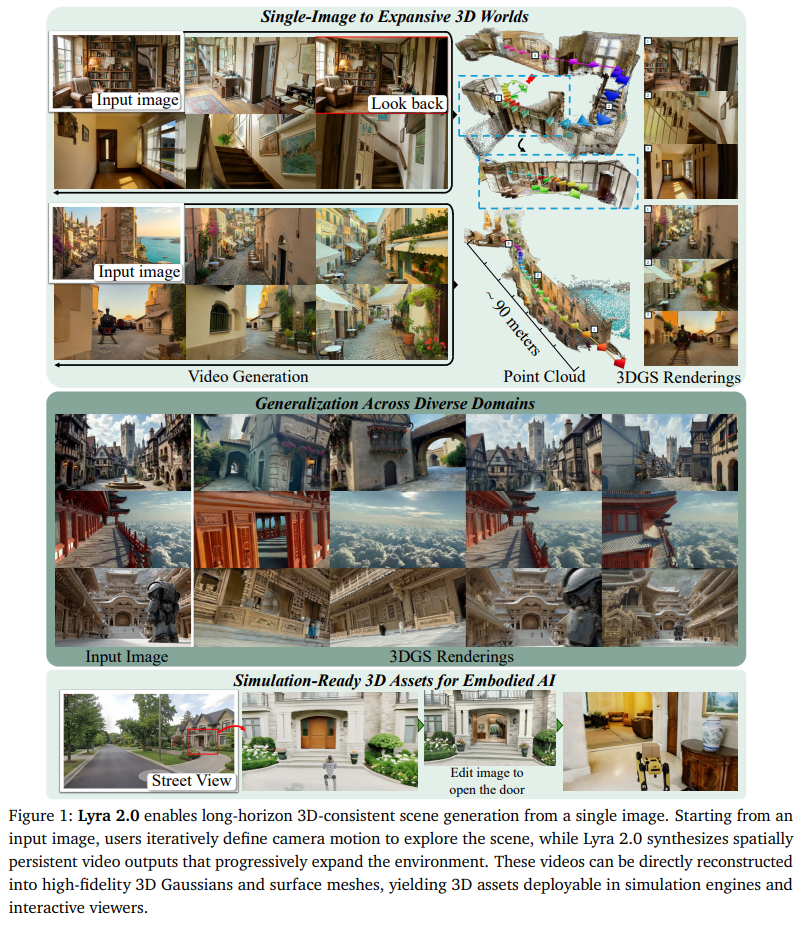
Lyra 2.0은 single image와 사용자가 지정한 camera trajectory를 기반으로, 장시간 탐색 가능한 3D-consistent world를 생성하는 framework다. 기존 camera-conditioned video generation은 짧은 구간에서는 높은 품질과 좋은 카메라 제어를 보이지만, 긴 autoregressive generation에서는 두 가지 문제가 발생한다:
- 하나는 과거에 보았던 영역이 temporal context 밖으로 밀려난 뒤 다시 방문했을 때 구조를 제대로 기억하지 못하는 spatial forgetting.
- 다른 하나는 generation 과정의 작은 오류가 누적되면 색상이나 geometry가 점차 무너지는 temporal drifting이다.
기존 연구들은 이러한 문제를 해결하기 위해 camera pose나 Plücker ray, depth warping 같은 방식으로 카메라 정보를 주입하거나, 과거 frame retrieval, global 3D memory, latent/KV cache, FramePack 기반 history compression 등을 사용해 long-term consistency를 유지하려 했다. 하지만 global 3D representation을 직접 conditioning에 사용하는 방식은 부정확한 depth나 generation artifact가 누적되며 오히려 오류를 증폭시킬 수 있고, 단순히 history frame만 추가하는 방식은 큰 viewpoint 변화에서 정확한 geometric correspondence를 찾기 어렵다는 한계가 있다.
Lyra 2.0은 이를 해결하기 위해 각 frame의 3D geometry를 하나의 global scene으로 fusion하지 않고 per-frame 3D memory로 유지하며, geometry는 appearance를 직접 생성하는 용도가 아니라 relevant history frame retrieval과 dense correspondence를 계산하는 information routing 용도로만 사용한다. 또한 모델 자신의 불완전한 generation을 history condition으로 사용하는 self-augmentation을 통해 temporal drifting에 대한 robustness를 높이며, 생성된 video는 Gaussian과 surface mesh로 변환되어, 기존 generative reconstruction 방식보다 더 넓고 지속적인 3D scene exploration을 가능하게 한다.
Method & Technical Details
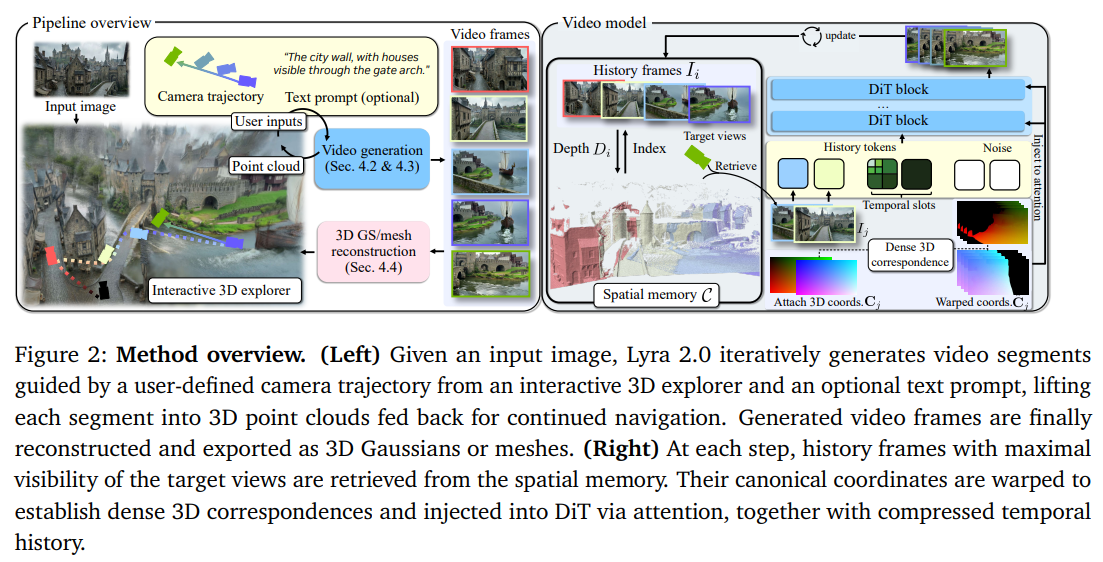
먼저, 전체적인 파이프라인을 살펴보고자 한다.
Lyra 2.0의 입력은 크게 3가지다:
- single image $I_0$
- 사용자가 지정한 전체 카메라 trajectory ${(T_i, K_i)}_{i=0}^{T-1}$
- 그리고 선택적으로(optional) text prompt
그런데, 이 trajectory 전체에 대해 한 번에 영상을 생성하는 게 아니라, autoregressive한 retrieve-generate-update loop를 반복한다(아마도, 기존 Lyra 논문에서 언급한 future work에 대한 연구를 진행한 것 같다).
즉, 현재 생성해야 할 다음 구간의 target viewpoint가 주어지면, 먼저 과거 frame 중에서 그 viewpoint와 3D적으로 가장 관련 있는 frame을 찾아오고, 그 정보를 이용해 다음 video segment를 생성한 뒤, 새로 생성된 frame과 geometry를 다시 memory에 추가한다.
조금 더 풀어서 설명하면:
- Retrieve: 지금 생성하려는 target view와 3D overlap이 큰 과거 frame들을 spatial memory에서 선택
- Generate: 선택한 spatial history와 최근 temporal history를 같이 condition으로 사용해서 다음 video chunk 생성
- Update: 새로 생성된 frame의 depth와 3D point cloud를 추정해서 spatial memory에 추가
그래서 생성될수록 memory가 계속 커지는데, 중요한 점은 이 memory가 단순한 “이전 몇 프레임”만 보관하는 temporal context가 아니라, 수백 프레임 전에 봤던 공간도 3D 위치를 기준으로 다시 찾을 수 있는 spatial memory라는 점이다.
그래서 위의 overview figure의 왼쪽 block을 보면,
\[\text{Input image} \rightarrow \text{camera trajectory} \rightarrow \text{video generation} \rightarrow \text{point cloud update}\]가 만족되고, 최종적으로 생성된 video frame들을 이용해 3DGS 또는 mesh reconstruction을 수행한다.
우리는 앞의 Introduction에서 두 가지의 큰 문제를 짚었다. forgetting과 drifting이다. 논문에서는 이 두 문제를 해결하기 위해 두 핵심 모듈을 설명한다. 이에 대한 자세한 이야기는 밑에서 다룰 예정이다.
Anti-Forgetting for 3D-Persistent Video Generation
해당 technique은 아래의 질문에 답하는 기술이다.
카메라가 아주 오래전에 봤던 장소를 다시 바라봤을 때, 그 공간을 어떻게 기억해서 이전과 같은 모습으로 생성할 것인가?
Lyra 2.0은 이 문제를 해결하기 위해 3D geometry를 appearance를 직접 만드는 조건으로 사용하지 않고, “어떤 과거 frame을 다시 가져와야 하는지”와 “그 frame의 어느 위치가 현재 view의 어디와 대응되는지”를 알려주는 information routing 용도로만 사용한다.
Anti-forgetting을 위한 모듈의 큰 흐름은 이렇게 볼 수 있다:
\[\boxed{ \text{3D cache 구축} \rightarrow \text{Geometry-Aware Retrieval} \rightarrow \text{Spatial Memory Injection} }\]즉,
- 지금까지 생성한 모든 frame의 3D 정보를 저장하고,
- 현재 생성하려는 target view와 관련 있는 과거 frame을 찾고,
- 그 frame과 target view 사이의 3D correspondence를 만들어 video model에 넣는다.
Building the 3D Cache
먼저, Lyra 2.0은 영상이 생성될 때마다 3D cache $\mathcal{C}$를 업데이트한다.
각 frame $I_i$에 대해 이미 알고 있거나 추정한 값은
\[I_i, D_i, T_i, K_i\]순서대로, RGB frame, estimated depth, camera extrinsic, camera intrinsic 이다.
그리고 depth $D_i$를 이용해서 3D point cloud를 만든다. 논문에서는 이를
\[P_i \in \mathbb{R}^{(\frac{H}{d}) \times \frac{W}{d} \times 3}\]로 표현한다. 즉, full-resolution depth를 그대로 모두 point cloud로 만드는 게 아니라 $d$배 subsampling하고 world coordinate로 unproject한다. appendix에서는 $d$를 8로 사용한다.
그런데 Lyra 2.0은 하나의 global point cloud로 합치지 않는다.
보통 생각하면 모든 frame에서 나온 point cloud를
\[P_0, P_1, ...\]하나로 합쳐서 $P_{global}$을 만들면 좋을 것 같지만, Lyra 2.0은 그렇게 하지 않는다.
각 frame의 geometry를
\[P_0, P_1, ...\]독립적으로 보관한다. 왜냐하면 depth는 ground truth가 아니라 generated image에서 추정된 depth이기 때문이다. 실제로, 같은 물체를 보더라도 매 프레임에서 depth estimator가 다른 값으로 추정할 수 있다. 하나의 global point cloud에 계속 fusion하게 되면 depth error가 발생하고 cross-view misalignment가 발생하며 corrupted global geometry가 누적된다.
그래서 Lyra 2.0은 Per-frame 3D geometry를 유지한다.
Geometry-Aware Retrieval
이제 새로운 target viewpoint에서 frame을 생성해야 한다고 해보자.
target camera가
\[(T^*, K^*)\]라 하자. 문제는 history frame이 수백 장 있을 수 있는데, 그걸 전부 DiT에 넣을 수 없다. 따라서 현재 target view와 가장 관련 있는 history frame $N_s$개만 골라야 한다. 논문에서는 이를 5로 사용한다.
그러면, 어떤 frame이 target view와 관련 있는지 어떻게 측정하는지 알아야 한다.
각 history frame의 point cloud $P_i$를 target camera $(T^, K^)$로 projection한다. 즉,
\[P_i \xrightarrow{T^*, K^*} \text{target image plane}\]으로 가져온다. 그러면 과거 frame에서 봤던 3D point들이 현재 target camera에서 어디에 보일지 알 수 있다. 특정 과거 frame의 point가 현재 target image 영역에 들어오는 양을 확인할 수 있다.
여기서 그냥 projection된 point 개수만 세는 것이 아니라 뒤쪽에 가려진 point도 projection 자체는 target image 위에 나타날 수 있기 때문이다. 그래서 각 target pixel에서 여러 point가 투영되면
\[d_{min}(u,v)\]즉 가장 가까운 projected depth를 구한다. history frame $i$에서 온 point의 depth를 $d_i$라고 하면,
\[|d_i - d_{min}| < \delta\]인 경우에만 visible이라고 본다. appendix에서는 $\delta$를 0.1 normalized depth unit을 사용한다. 따라서 occlusion 가려진 뒤쪽 point는 visibility 계산에서 제외된다.
그렇게 visible이라고 판단된 point의 개수를 세어서
\[\phi(i)\]를 만든다. 즉, 현재 target view에서 보이는 $P_i$의 point 수라고 보면 된다. 예를 들어, $\phi(20)=5000, \; \phi(300) = 120$ 이라면, 20 frame이 훨씬 관련있다고 보는 것이다. 이는 시간적으로 얼마나 가까운 frame인지가 아니라 spatial overlap을 본다는 것이다.
그리고 Training과 Inference에서 retrieval 방식이 조금 다르다. Training에서는 visibility score에 비례해서 sampling을 진행한다. 즉, 가장 좋은 frame만 항상 고르는 것이 아니라 visibility가 높은 frame이 더 높은 확률로 선택되도록 한다. 이는 retrieval 결과가 조금 달라져도 모델이 robust하게 동작하도록 하기 위해서다.
Inference에서는 greedy coverage를 사용한다. 단순히 상위 몇개를 고르는 방식을 사용하지 않는다는 뜻이다. 왜냐하면 상위 몇개가 모두 거의 같은 위치에서 찍은 frame일 수도 있기 때문이다. 그래서 inference에서는
- 아직 cover되지 않은 target pixel을 가장 많이 cover하는 frame 선택
- 해당 영역을 covered로 표시
- 남은 영역을 많이 cover하는 frame 선택
- 반복
해서 $N_s$개를 고른다. 이 덕분에 서로 다른 viewpoint의 history frame을 선택할 가능성이 높아진다.
Injecting Spatial Memory into the Video model
우리는 이제 어떤 history frame을 사용할지 결정했다. 이제 선택한 history frame들을
\[\{I_j\}_{j=0}^{N_s - 1}\]이라고 하자. 이 frame들을 spatial slots로 만든다. 각 frame을 VAE로 독립적으로 encode한다.
여기서 중요한 건 일반 video처럼 temporal compression을 하지 않고 image token으로 independently encoding한다는 것이다. 왜냐하면, 우리가 선택한 history frame들은 시간적으로 연속된 5 frame이 아니기 때문이다. 그래서 각각 한 장의 image로 독립적으로 encode 한다는 뜻이다.
그러면, VAE compression으로 인해 spatial downsampling이 적용된다.
\[H \times W \rightarrow \frac{H}{8} \times \frac{W}{8}\]그리고 나서, FramePack의 spatial compression(Patchification/subsampling)을 적용한다. 이미 만들어진 latent/token을 추가로 spatial subsampling해서 token 수를 줄이는 것이다.
\[f_{nkm}\]이 표현은 n개의 frame을 spatial subsampling factor m으로 압축한다는 의미다. 예시를 들어보자면, 우리가 만약 history frame 5장을 골랐을 때:
\[I_{20}, I_{105}, I_{230}, I_{450}, I_{700}\]이 5장은 먼저 각각 독립적으로 VAE를 통과한다. 그런데 5장을 모두 full-resolution token으로 넣으면 비싸므로 그 중에서 4장은 $k=2$로 spatially compress하고, 한 장은 $k=1$, 즉 VAE encoder를 지난 후의 resolution을 유지한다.
따라서 이걸 $f_{4k2}, f_{1k1}$이라고 쓰는 것이다. 단순하게,
retrieved history 5장 중 4장은 저해상도 token으로 넣고, 1장은 고해상도 token으로 넣는다.
라는 의미다.
그런데 history image만 넣어주게 되면 모델이 history image의 특정 pixel과 target image의 특정 pixel이 같은 3D point 라는 걸 알기 어렵다.
그래서 Dense 3D Correspondence를 추가한다.
각 retrieved frame $j$에 대해서 canonical coordinate map
\[C_j \in [-1,1]^{3 \times H \times W}\]를 만든다. 각 pixel은
\[C_j(u,v) = (u,v,2\frac{j}{N_s}-1)\]로 표현된다. 앞의 두 채널 $u,v$는 그 pixel이 source image의 어디에 있었는지를 나타낸다. 세 번째 값은 어떤 spatial slot/frame에서 온 pixel인지를 구분하는 frame identity 역할을 한다.
즉,
\[(u,v,j)\]에 가까운 정보를 3채널 coordinate로 encode한다고 보면 된다.
이제 source frame의 depth $D_{s_j}$와 camera pose를 사용해서 $C_j$를 target camera로 forward warp한다:
\[\hat{C_j} = FwdWarp(C_j, D_{s_j}, T_{s_j}, T^*, K_{s_j}, K^*)\]이 뜻은
\[\text{source pixel} \rightarrow \text{3D world} \rightarrow \text{target pixel}\]이다. 그래서 target image의 어떤 위치에 $(u_s, v_s, j)$가 나타나면, “target의 이 pixel 위치는 spatial memory의 j번째 image에서 $(u_s,v_s)$ 위치와 대응된다”는 것을 의미한다.
canonical coordinate 3채널에 추가로 depth도 warp해서 각 source frame(우리가 선택한 5개의 history frame) 마다
\[[\hat{C_j}; \hat{D_j}]\]라는 4-channel correspondence map을 만든다. 즉, (u,v,frame ID, depth)정보가 들어있는 셈이다. 그러므로 단순한 2D correspondence가 아니라 3D-aware dense correspondence가 된다.
이 correspondence map
\[[\hat{C_j}; \hat{D_j}]\]을 positional encoding하고 MLP를 거쳐 embedding으로 만든다. 구체적으로,
\[[\hat{C_j}; \hat{D_j}] \rightarrow \text{pixel shuffling} \rightarrow \text{sinusoidal positional encoding} \rightarrow \text{linear projection}\]을 통해 token dimension을 맞춘다. 그리고 이 embedding은 transformer의 Q와 K에 추가된다.
\[q = W_Q(x+p_{corr}) \\ k = W_K(x+p_{corr})\]반면, value는 건드리지 않는다. 이는 어떤 token이 어떤 spatial-memory token을 봐야하는지를 attention에 알려주기 위한 것이기 때문이다.
즉, Q와 K를 수정하며 attention matching을 유도하지만, 실제 appearance information을 담은 V는 pretrained video model의 feature를 그대로 유지한다.
위의 내용이 좀 길었다. 그러면 일단 정리해보자면, DiT에 들어가는 입력은 결국
\[X = [X_{anchor}, X_{spatial}, X_{temporal}, X_{generate}]\]라고 생각하면 된다.
여기서 Anchor는 처음 입력한 이미지 $I_0$를 의미하고, Spatial token의 경우에는 3D retrieval로 골라온 history frame 5장의 VAE feature, Temporal Token은 최근 generation history를 FramePack으로 압축한 feature, Generate token은 현재 만들려고 하는 target video chunk의 noisy latent다.
그리고, correspondence map은 위의 입력처럼 concat되어서 들어가는 방식이 아니라 processing을 거쳐 attention을 조정하는 embedding이 되어 DiT의 Q와 K에 들어간다.
Anti-Drifting for Long-Horizon video Generation
학습할 때 모델은 보통 깨끗한 ground-truth history frame을 condition으로 받는다. 그런데, inference에서는 ground truth가 없으니까 이전에 자기 자신이 생성한 frame을 condition으로 써야 한다. 즉,
\[\hat{x}^{hist} \rightarrow \text{다음 chunk 생성}\]그런데, 이전 generation에 blur, color shift, 작은 geometry error가 조금이라도 있으면, 다음 chunk는 그 imperfect history를 보고 생성되고, 그 다음 chunk는 또 그 결과를 보고 생성한다. 그래서 error가 누적될 수 있다.
논문에서는 이를 observation bias라고 부른다.
Lyra 2.0은 이미 FramePack을 사용하고 있는데, 오래된 history를 강하게 compress하고 최근 history는 더 fine하게 유지해서, 제한된 token budget 안에서 더 긴 temporal context를 볼 수 있게 한다. 또 initial image를 anchor로 계속 유지하니까, $I_0$와 너무 멀리 drift하는 것도 어느 정도 막아준다.
하지만 논문은 FramePack은 imperfect history를 보고 correct output을 생성하도록 학습하는 것이 아니라 더 긴 history를 볼 수 있게 하는 것이다. 그래서 train-test gap은 여전히 남는다.
논문은 관련 연구로 Self-forcing이라는 아이디어를 말한다. 이는 training 때도 모델이 자기 prediction을 condition으로 보게 만들어 train-test gap을 줄이는 방식이지만, 실제 inference와 비슷한 history를 training 중에 만들려면 매번 history segment를 완전히 생성해야 한다. 그래서 training sample 하나를 만들기 위해서 history에 대해 여러 번 denoising해야 할 수 있기 때문에 너무 비싸다는 점이다.
그래서 저자들은 Self-Augmentation Training을 제안한다. 간단하게,
학습할 때도 inference처럼 “조금 망가진 history”를 보게 해서, 그 상태에서도 다음 chunk를 잘 생성하도록 만드는 것.
먼저, training sample을
\[x^{hist}, x^{cur}\]로 이전 history segment와 현재 생성해야 할 target chunk로 나눈다. 그리고 먼저 둘 다 ground truth를 사용해서 VAE encoding을 한다.
\[z_0^{hist} = \mathcal{E}(x^{hist})\]current chunk는 causal VAE이므로 history cache를 condition으로 사용해서
\[z_0^{cur} = \mathcal{E}(x^{cur} | x^{hist})\]를 얻는다.
이제 확률 $p_{aug}=0.7$로 history에 self-augmentation을 진행한다. $p_{aug}$는 training sample 하나가 들어왔을 때, 어떤 확률을 통해 할지 말지를 결정하는 확률값이다. 그리고,
\[t \sim \mathcal{U}(0, 0.5)\]를 통해 0~0.5 사이의 uniform distribution에서 t를 하나 sampling한다. 이는 history를 얼마나 심하게 망가뜨릴지 결정하는 noise strength라고 보면 된다. 자 이제 $t$를 뽑고,
\[z_t^{hist} = (1-t)z_0^{hist} + t \epsilon\]history latent에 noise를 넣는다. 즉, noisy history를 만들게 된다. 그러나, 이 noisy history를 그대로 condition으로 쓰지는 않고, video model로 딱 한 번 denoising한다.
\[\tilde{z}_0^{hist} = z_t^{hist} - t v_{\theta}(z_t^{hist}, t, c)\]그래서
\[\tilde{z}_0^{hist}\]라는 약간 imperfect한 pseudo-history를 만든다. 그래서 clean history가 아닌 이 $\tilde{z}_0^{hist}$를 conditioning으로 넣는다.
여기서 중요한 건 target은 clean하게 유지한다. 즉 supervision은
\[z_0^{cur}\]라는 clean target을 사용한다.
이렇게 하면, 모델 자체의 bias나 reconstruction error를 통해 나타나는 error propagation에 robust해질 수 있다는 것이 저자들의 주장이다.
3D Reconstruction
앞에서 생성한 긴 3D-consistent video를 실제 3DGS와 mesh로 변환해야 한다.
저자들은 Depth Anything V3를 사용해서 입력 frame들로부터 per-pixel 3DGS attribute를 feed-forward 방식으로 예측한다. 그런데 원래 DA3는 pixel 하나당 Gaussian 하나를 생성하기 때문에 고해상도 video에서는 Gaussian의 수가 너무 많아져서 이를 해결하기 위해 Gaussian DPT head의 출력 feature map을 $K \times K$만큼 downsampling하도록 수정한다. 그러면 가우시안의 개수는 $\frac{1}{k^2}$만큼 줄어든다. 실제 설정은 $k=2$다.
필요하면 3DGS를 surface mesh로 변환한다. OpenVDB 기반의 hierarchical sparse grid를 사용한다. 3DGS는 Gaussian 점들의 집합이라서 렌더링에는 좋지만, Isaac Sim 같은 simulation에서 물체 표면이나 충돌을 쓰려면 triangle mesh가 더 편할 수 있다. 그래서 Gaussian으로부터 depth를 렌더링하고, 그 depth를 이용해 surface를 복원한다.
surface를 복원하는 방법은 3D로 unprojection 되었을 때 3D point의 surface 방향을 계산하기 위해서 normal vector $n$을 계산해야 한다. 이 normal을 계산하기 위해서 depth의 gradient를 이용한다. 그래서
\[(p,n)\]이렇게 하나의 point 형태가 완성되고, 이런 point 집합을 oriented point cloud라고 부른다. 추가적으로 Signed Distance Field라는 개념이 등장하는데, 이건 가장 가까운 surface까지 얼마나 떨어져 있으며, surface 바깥에 있는지 안에 있는지를 sign(부호)로 추가로 표현하는 방식이다.
surface 위에서는 $S(x)=0$, surface 바깥에서는 $S(x)>0$, 안에서는 $S(x)<0$이다. 그리고 Marching Cubes는 SDF의 0인 곳을 mesh로 만든다. 그래서 $S(x)=0$인 곳이 surface다. Marching cubes는 voxel grid를 돌아다니면서 이 voxel 안에서 SDF 값이 +에서 -로 바뀌는 위치가 어디인지 확인하고 triangle mesh로 만든다.
Distilled Model for Accelerated Inference
원래 Lyra 2.0의 경우에는 inference에서 35-step denoising을 한다. 저자들은 이 모델을 teacher로 두고, DMD를 사용해 4-step student model을 학습시킨다.
그리고, CFG도 함께 distill한다. 원래 CFG를 사용하면 inference 때 conditional / unconditional prediction을 따로 계산해야 해서 한 denoising step마다 보통 forward 두 번이 필요하다. Lyra 2.0은 이 guidance effect 자체도 student에 흡수시켜서, inference 때는 별도의 conditional / unconditional 두 번의 forward 없이 single-pass로 작동하도록 한다.
추가로, distillation 중에서도 self-augmentation을 그대로 유지한다.
여기서 appendix 기준으로 distilled model의 80-frame step이 15초로(기존 full model은 194초) 약 13배 단축되었다고 보고한다.
Experiments
Training Details
Lyra 2.0은 DL3DV 데이터셋으로 학습되며, camera pose는 ViPE, depth는 Depth Anything V3, caption은 Qwen3-VL-8B-Instruct를 사용한다. 학습 시 30%는 single-image conditioned I2V 방식, 나머지 70%는 이전 frame을 history로 사용하는 autoregressive chunk-based 방식으로 학습한다.
Long Video Generation & 3D Scene Generation
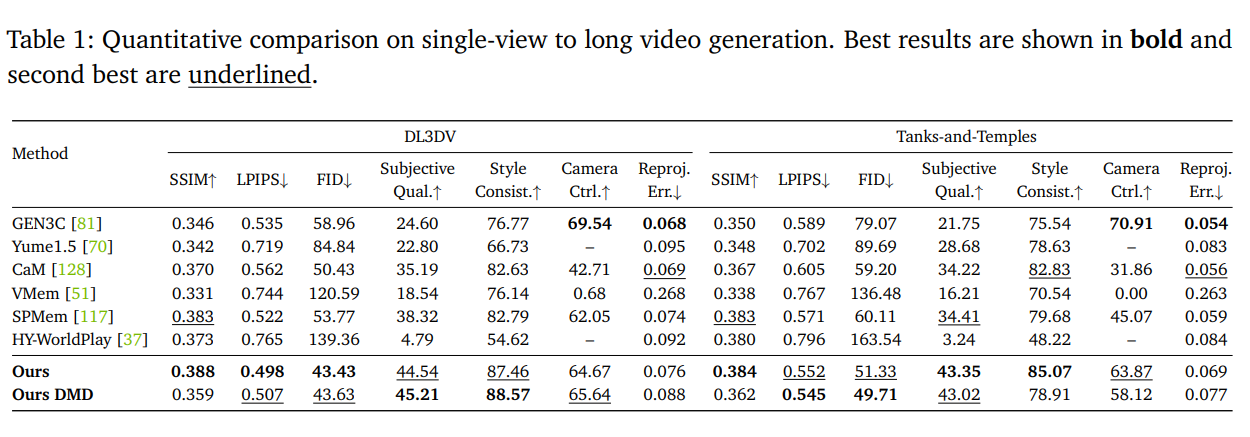
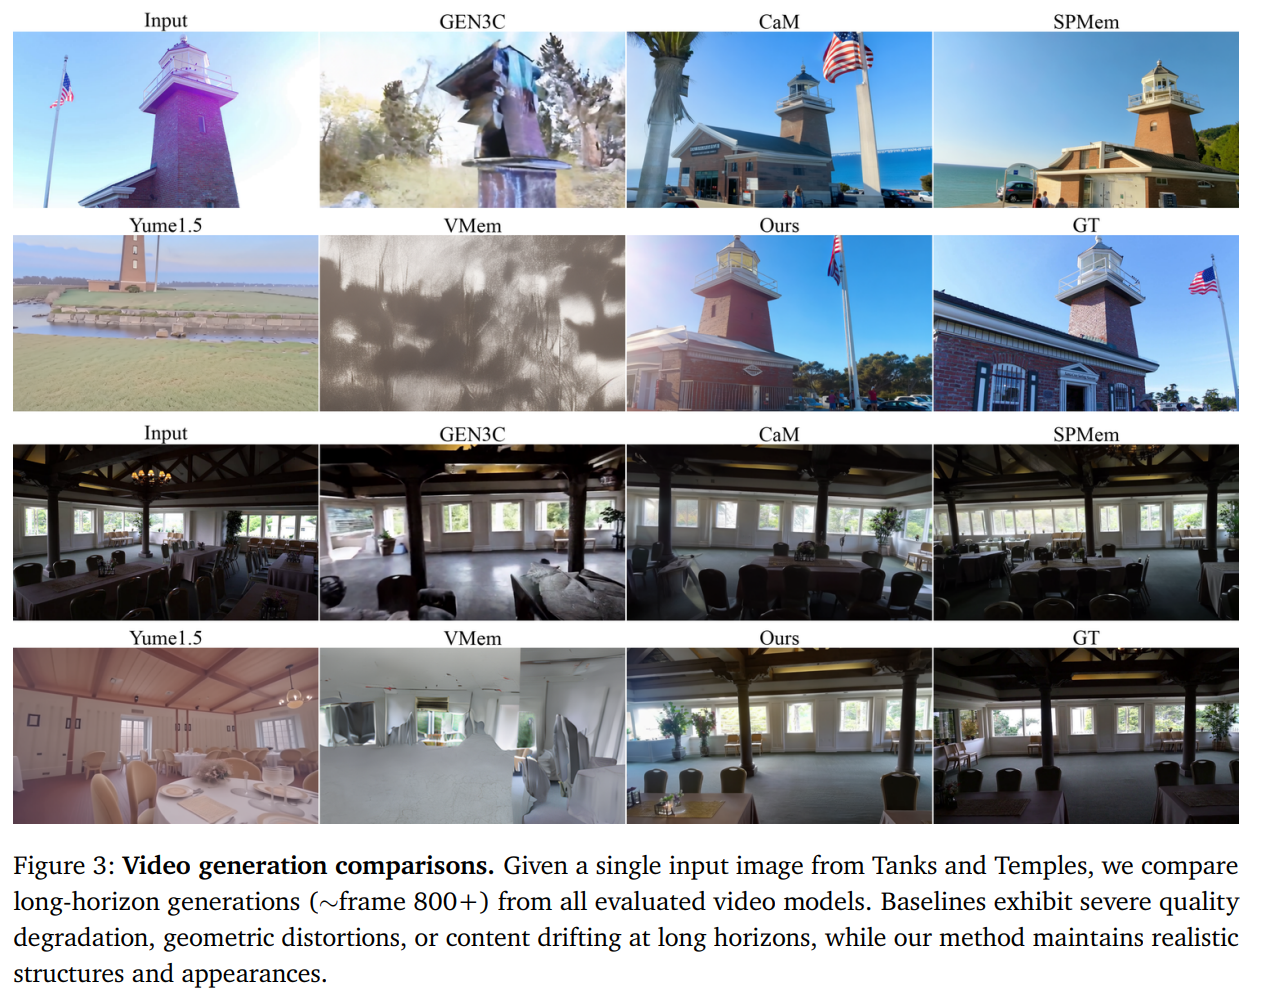
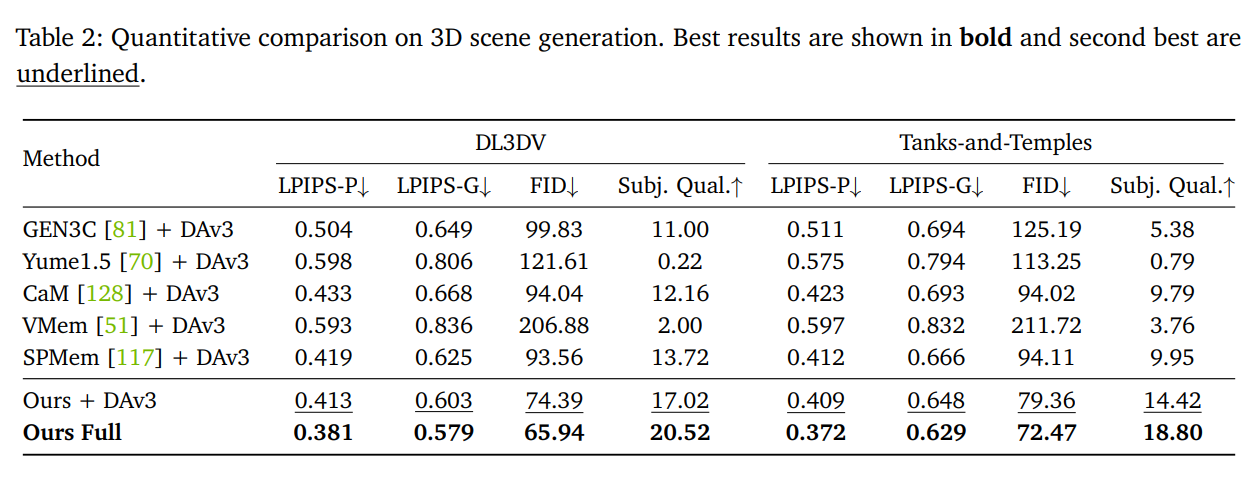
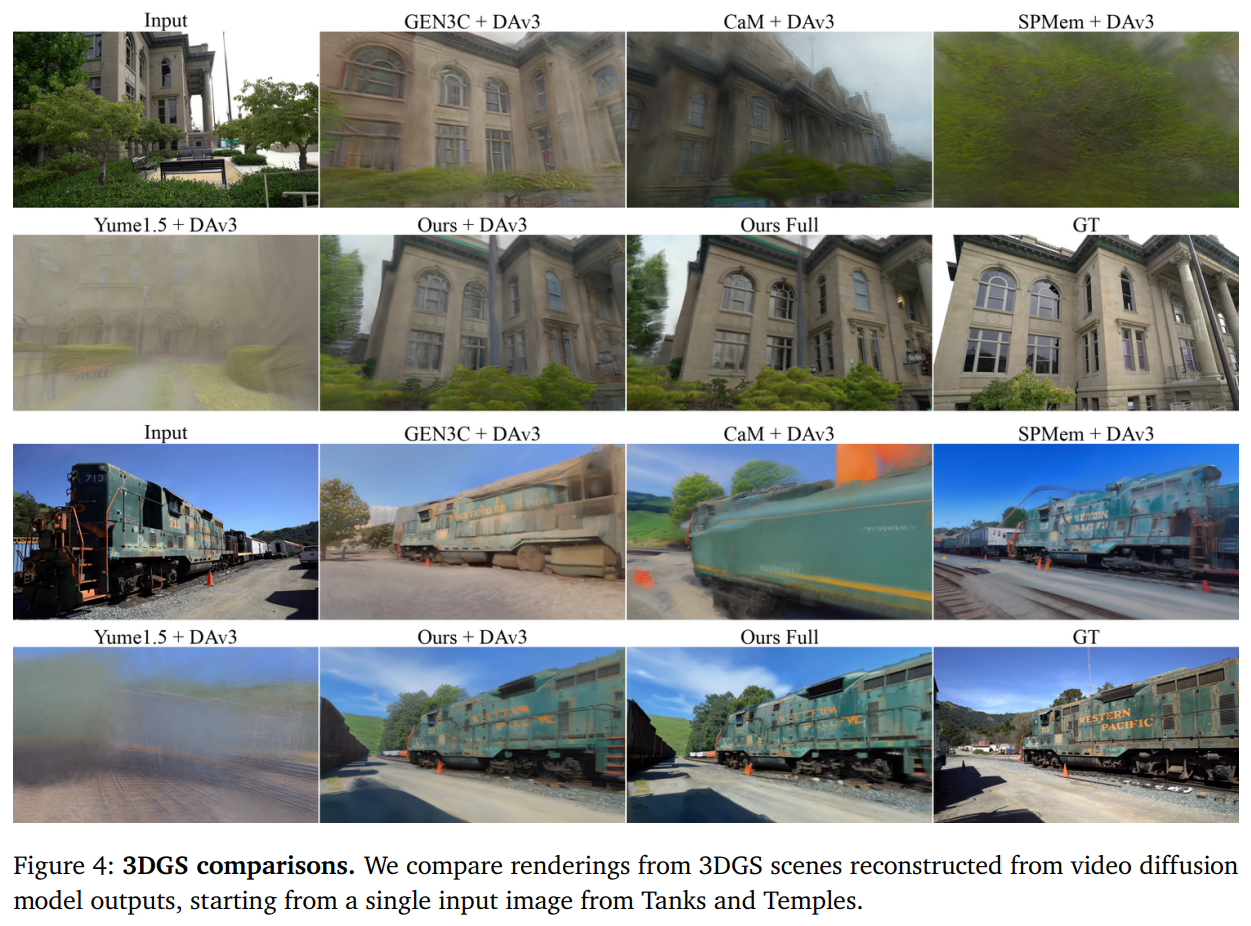
비교 대상은 GEN3C, Yume-1.5, CaM, VMem, SPMem, HY-WorldPlay이며, DL3DV-Evaluation과 Tanks and Temples에서 평가한다. 주요 지표는 SSIM, LPIPS, FID, Subjective Quality, Style Consistency, Camera Controllability, Reprojection Error이다.
Lyra 2.0은 대부분의 지표에서 가장 좋은 성능을 보였으며, 특히 긴 generation에서도 visual quality, camera control, long-range consistency를 잘 유지했다. DMD 버전은 denoising step을 35회에서 4회로 줄이면서도 비슷한 품질을 유지했지만, camera controllability는 다소 감소했다.
생성된 video를 DAv3로 3DGS reconstruction한 뒤, LPIPS-P, LPIPS-G, FID, Subjective Quality로 평가한다. 특히 Ours Full, 즉 Lyra-generated video로 fine-tuning된 DAv3를 사용한 경우 가장 좋은 성능을 보였으며, generated video의 3D consistency가 실제 reconstruction 품질 향상으로 이어지는 것을 확인했다.
Ablation Study
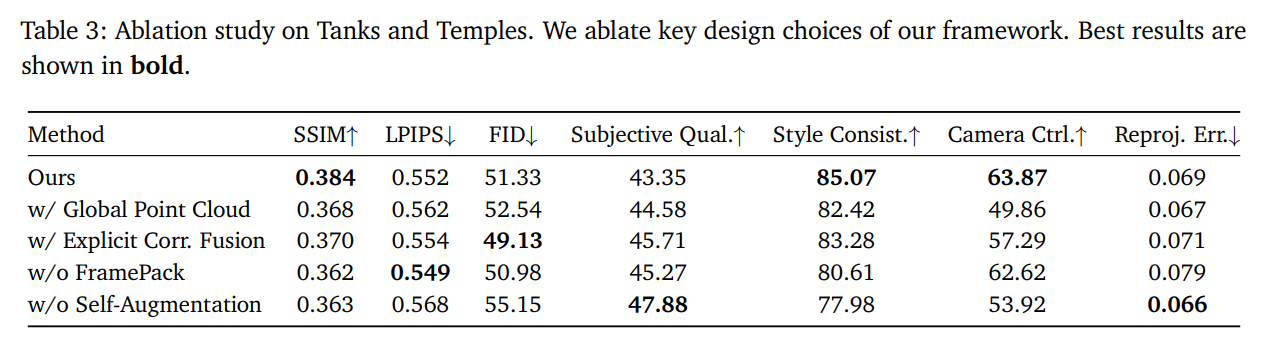
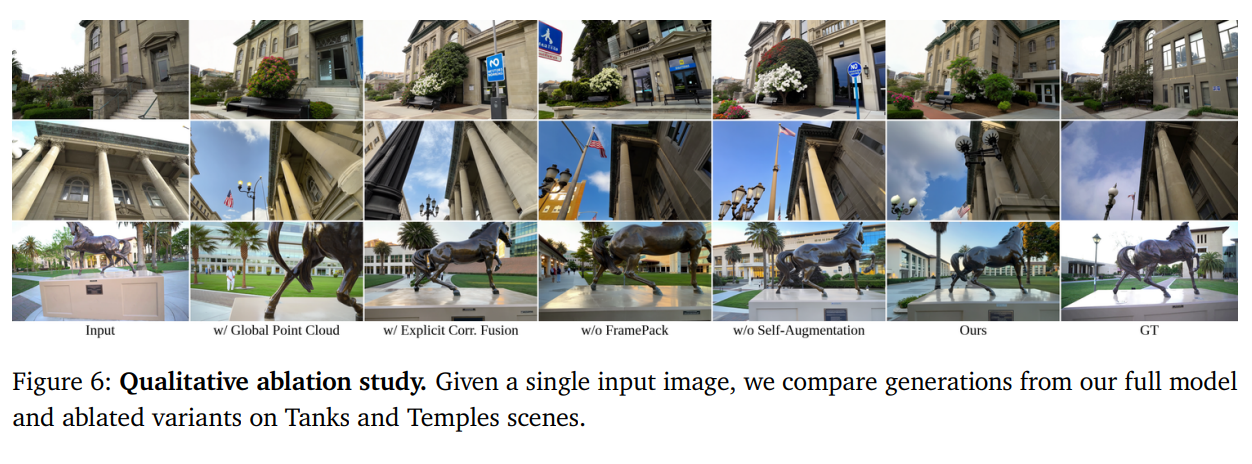
주요 ablation은 다음과 같다.
- Global Point Cloud: depth error 누적으로 camera control과 style consistency가 감소
- Explicit Correspondence Fusion: learned aggregation보다 성능이 낮음
- w/o FramePack: temporal drifting과 reprojection error 증가
- w/o Self-Augmentation: long-range style consistency와 camera controllability 감소
이를 통해 per-frame spatial memory, learned correspondence aggregation, FramePack, self-augmentation이 모두 중요함을 확인했다.
Applications
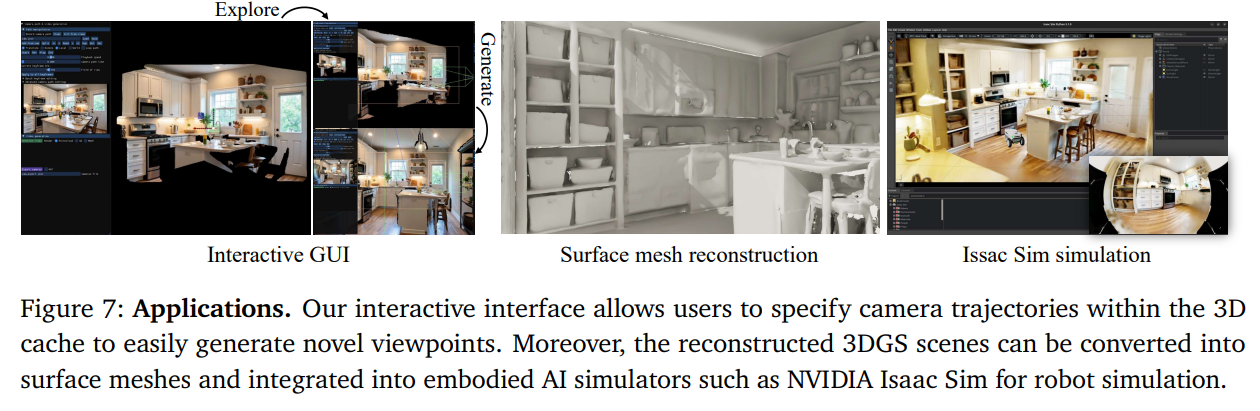
Lyra 2.0은 interactive GUI를 통한 scene exploration, in-the-wild single-image 3D scene generation, 그리고 생성된 mesh를 NVIDIA Isaac Sim에 넣어 embodied AI simulation에 활용하는 예시를 보여준다.
Contributions
- Per-frame 3D spatial memory와 dense correspondence를 활용한 anti-forgetting mechanism을 통해 long-horizon video generation에서 spatial consistency를 유지한다.
- Self-augmentation training을 통해 autoregressive generation의 error propagation과 temporal drifting을 완화한다.
- 생성된 long video를 feed-forward 3DGS reconstruction으로 변환하여 large-scale, explorable 3D world를 생성하고 simulation-ready mesh까지 제공한다.
Limitations & Future works
- 현재 Lyra 2.0은 static environment만을 대상으로 하며, dynamic scene은 명시적으로 모델링하지 않는다. 향후 dynamic scene으로의 확장이 필요하다.
- DL3DV의 exposure variation이 generated video에도 나타날 수 있으며, 이러한 photometric inconsistency는 3DGS reconstruction artifact를 유발할 수 있다.
- 향후에는 network의 photometric stability를 개선하거나, game engine 기반의 photometrically consistent synthetic dataset을 활용하여 보다 안정적인 3D scene generation을 수행할 수 있다.